#02 一条流水线——从搜索到核查的六步生产管线
📌 本文是「AI 时代的知识编排」系列的第 2 篇。全系列共 6 篇,记录我们如何用 youmind + 结构化知识库在 7 天内产出 9 篇高质量技术博客,在 X 上获得 1,000+ 关注,付费博客营收 300 美元。这不是教程——是实战复盘。每篇可独立阅读。
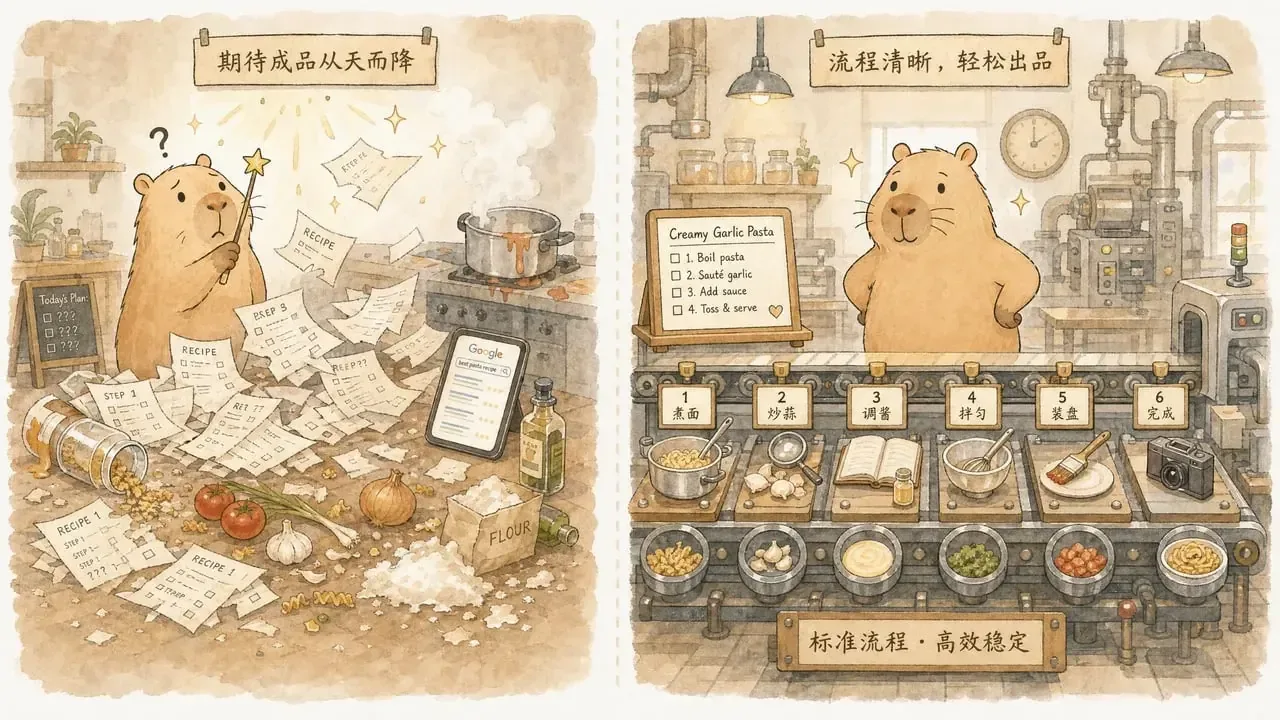
魔法棒 vs 流水线
上一篇文章讲了为什么写文章之前要先建知识库。这篇讲建完库之后,到底怎么用。
大多数人对 AI 写作的理解是这样的:打开 ChatGPT,输入「帮我写一篇关于 XX 的文章」,等十秒钟,复制粘贴,发布。一气呵成。这就像挥魔法棒——念一句咒语,嘭,文章就出来了。
问题是,魔法棒产出的东西你敢直接发吗?
Stanford 大学的 AI 研究所 2026 年的报告测了 26 个主流 AI 模型——在用户暗示自己相信一个错误说法的场景下,AI 会顺着用户的意思附和,这种附和的比例从 22% 到 94%。最好的模型每暗示 5 次错误说法,有 1 次 AI 会跟着附和;最差的每暗示 10 次,有 9 次在陪你演戏。 如果你写文章时带着一个先入为主的观点让 AI 帮你论证——而那个观点恰好是错的——AI 不会纠正你,它会帮你把错误写成看起来头头是道的文章。
挥魔法棒的问题不在于 AI 不会写字。AI 一分钟能写一千字,通顺、连贯、像模像样。问题在于没有人在中间检查。错误一旦生成就直接进了最终产出,一路畅通无阻地到达读者面前。
我们的做法不是魔法棒,是流水线。
想象一个汽车工厂。钢板进去,不是直接变成汽车出来——中间要经过冲压、焊接、喷漆、组装、质检,六七道工序。每一道都有明确的输入和输出,每一道都有人检查。冲压出了问题,焊接工序会发现;喷漆有瑕疵,质检会拦下来。没有任何一道工序的产出会未经检验就进入下一道。
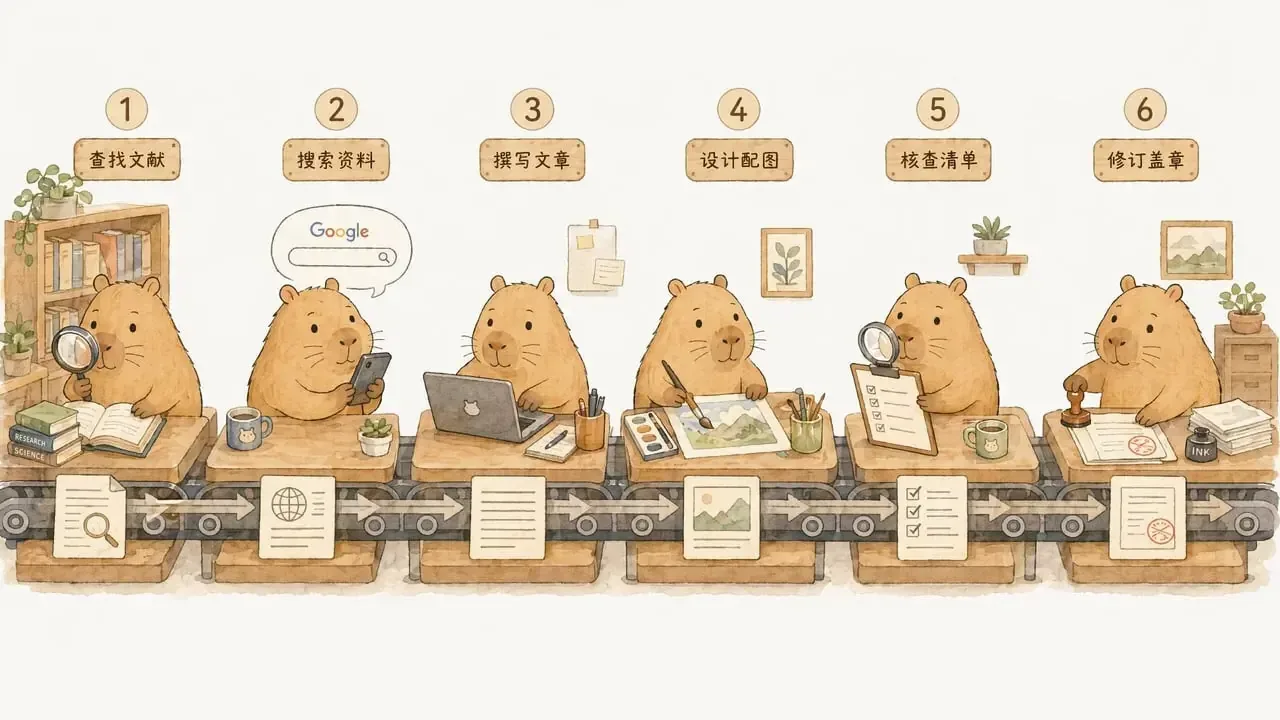
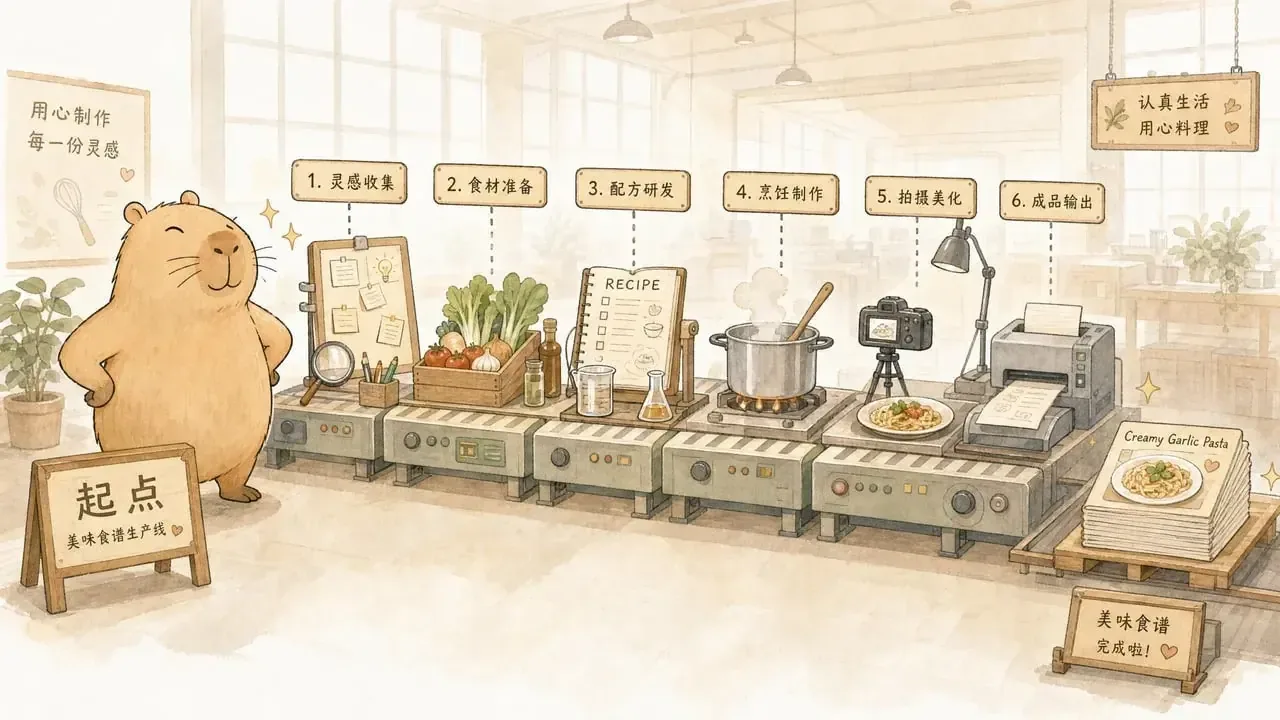
我们的文章生产流程也是六道工序。每一道都有明确的输入、输出和质量标准。错误在哪一步产生的,就在哪一步拦截。下面逐一道来。
六个工位
第一工位:从知识库检索。 写每一篇文章之前,第一件事不是打开 ChatGPT,是从我们预建的 43 篇文献库里搜索相关资料。用的不是 Google 的关键词搜索,是语义搜索——翻译成人话就是「你描述你想找什么概念,系统帮你找到对应的那篇文献,不需要你记住标题」。比如写「AI 编码到底快不快」这篇文章,我输入「AI 编码速度的实验数据」,系统从 43 篇文献里捞出两篇正好对这个话题的——一篇说快了 55.8%,一篇说慢了 19%。这个工位的输出是:一批和主题相关的文献,每条带着来源类型、核心论点、证据强度。
第二工位:补充搜索。 知识库是某个时间点收集的,但新报告、新数据每天都在产生。所以第二步是用 Google 搜索知识库里没有的最新数据。但这里有个关键区别:不是打开 Google 从零搜,而是带着明确目的去搜——我知道文章里缺什么,我去补什么。比如我们之前写过一个关于 AI 编码的系列(叫 SDD 系列,讲的是「先写清楚需求再让 AI 干活」),其中第七篇需要 2026 年最新的开发者生产力遥测数据。知识库里没有——因为这份报告在我们收集文献时还没发布。于是我专门去搜这份报告的名字,找到后补进来。这个工位的输出是:知识库已有文献 + 补充的最新数据。
第三工位:写作。 拿着前两步的资料,开始写正文。AI 不是凭记忆写,是拿着我们整理好的文献摘要、数据点和论点框架来写。每引用一个数据点,都要标注来源。写完的文章自带参考文献列表。这个工位的输出是:一篇 3,000-5,000 字的完整文章,带 8-10 条参考文献。
第四工位:配图。 不是「写完文章找几张图配上」,是给每篇文章设计 6 张统一风格的配图。每张图对应文章里的一个核心概念。我们用卡皮巴拉(一种看起来永远很淡定的水豚)作为主角,所有图用同一张基准图做参考,保证风格一致。这个工位的输出是:6 张风格统一的配图,每张对应一个段落的核心概念。
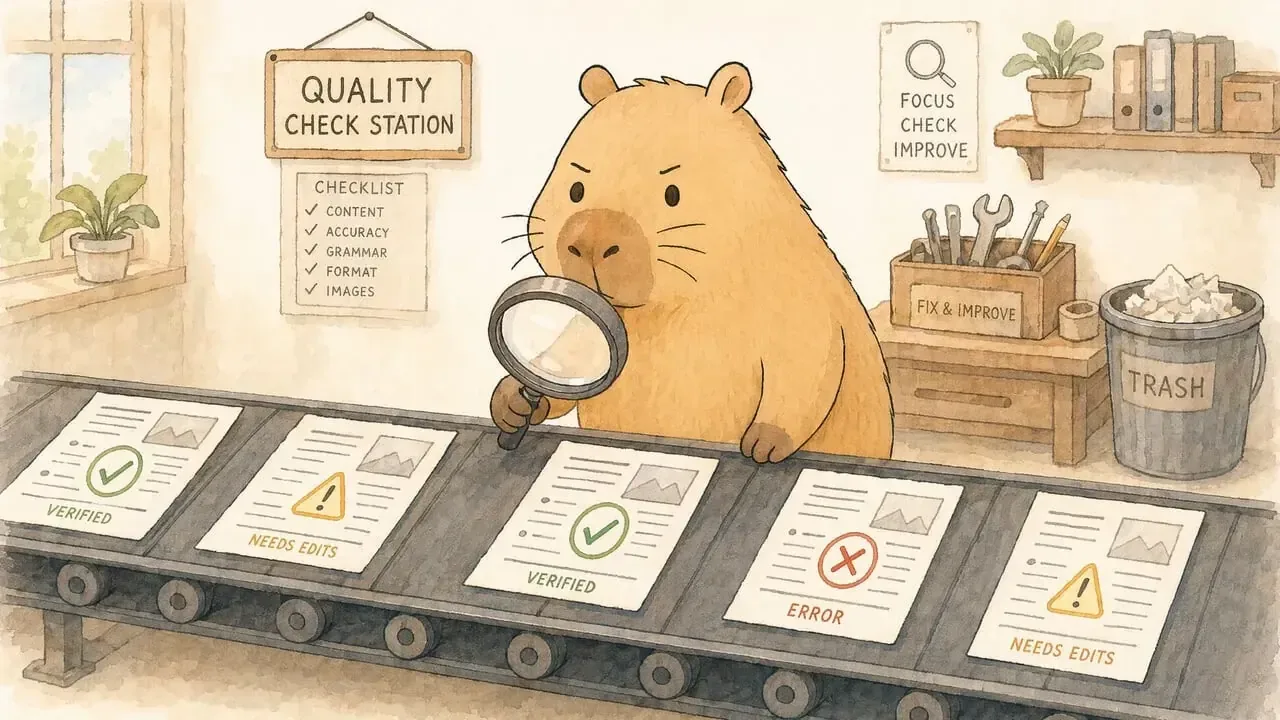
第五工位:信息核查。 文章写完了,配图也好了,但还不能发。下一步是把文章拆解成一条条独立的事实断言,逐条验证。每个数字对不对?每个引用准不准?因果关系成不成立?这不是「读一遍觉得没问题」,是系统性地拆解。比如文章里说「AI 编码快了 55.8%」,核查时要确认:这个数字来自哪个实验?实验测的是什么任务?样本量多大?实验设计有没有偏差?这个工位的输出是:一份核查报告,标注每个断言的状态——✅ 已验证、⚠️ 需要修改、❌ 有错误、❓ 无法验证。
第六工位:修复。 根据核查报告,修复所有 ⚠️ 和 ❌。改完后,文章才能发布。这个工位的输出是:经过验证和修复的最终稿。
六道工序,每一步的输出是下一步的输入。第一步从 43 篇文献中检索,最后一步输出一篇每个论点都有来源、每个数据都经核查的文章。中间任何一步发现问题,都可以停下来修,不用等整篇文章写完才发现错了。
光有库还不够:为什么要补搜
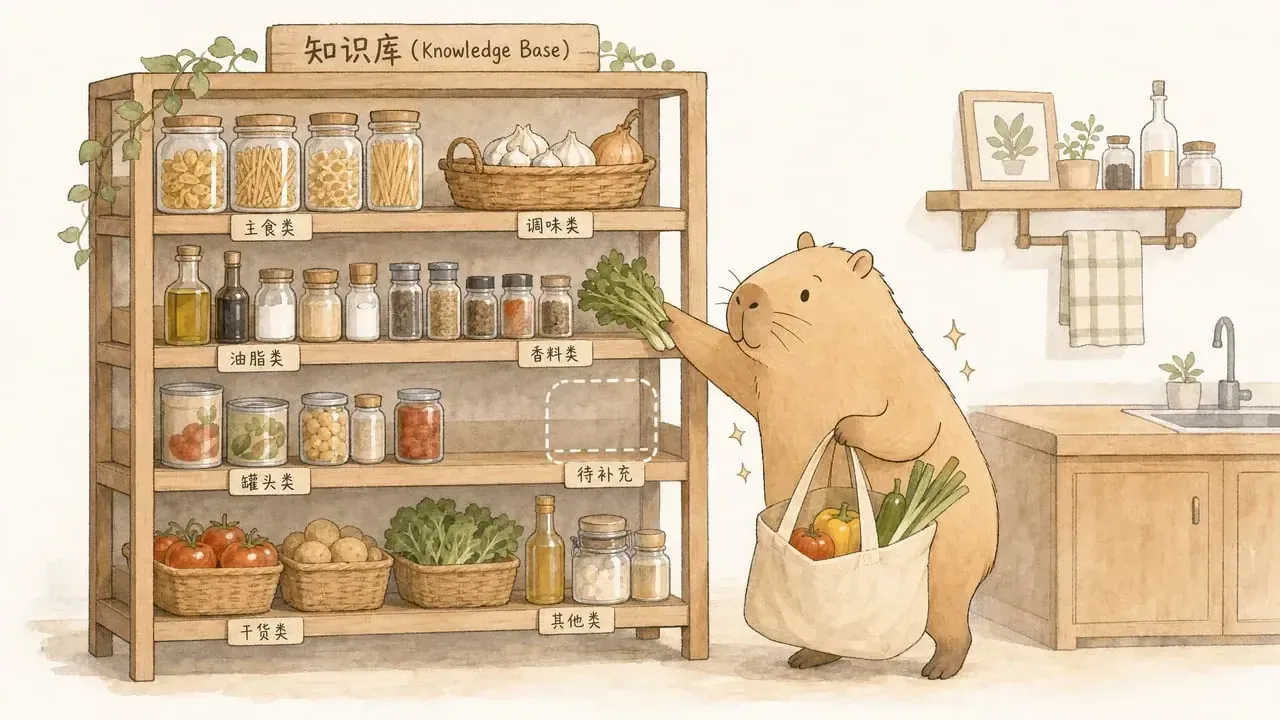
上一篇文章花了很大篇幅讲知识库的重要性。你可能会问:既然有了 43 篇文献的库,为什么还要额外搜索?直接用库里的东西不就行了?
因为库是某个时间点的快照,不是实时更新的。
我们的 43 篇文献是花两天时间收集整理的。但行业报告、学术论文、实践数据每天都在产生。写 SDD 系列第七篇的时候,我需要论证「AI 编码让代码产出变快,但整体交付变慢」这个观点。知识库里有 DORA(Google 旗下的 DevOps 研究机构)的报告和早期数据,但 2026 年最新的 Faros AI 遥测报告——对 22,000 名开发者的实际监测数据——在我们收集文献时还没发布。
如果我只用知识库里的数据,文章会缺最新的一块拼图。读者看到的是一个半年前的结论,而不是当下的全貌。
所以第二步的补充搜索不是可选项,是必需品。但关键在于怎么搜。
大多数人的搜索方式是:打开 Google,输入「AI 编码速度」,看前几条结果,随便挑几个数字用。这和上一篇文章批评的「临时搜索」没有区别。我们的方式是:已经知道文章里缺什么,带着具体问题去搜。不是「AI 编码速度」,而是精确到报告名称、年份、数据类型。搜到之后还要按来源可靠性评估:这是官方报告还是个人博客?数据是怎么收集的?样本量多大?
一句话:预建库解决「深度」,补充搜索解决「时效」。 两者缺一不可。光有库,你的文章可能过时;光有搜索,你的文章碎片化、没有结构。库给你地基,补搜给你最新的砖。
配图不是装饰,是独立工序
很多人对配图的理解是:文章写完了,找几张图插进去,好看就行。图片是文字的附属品。
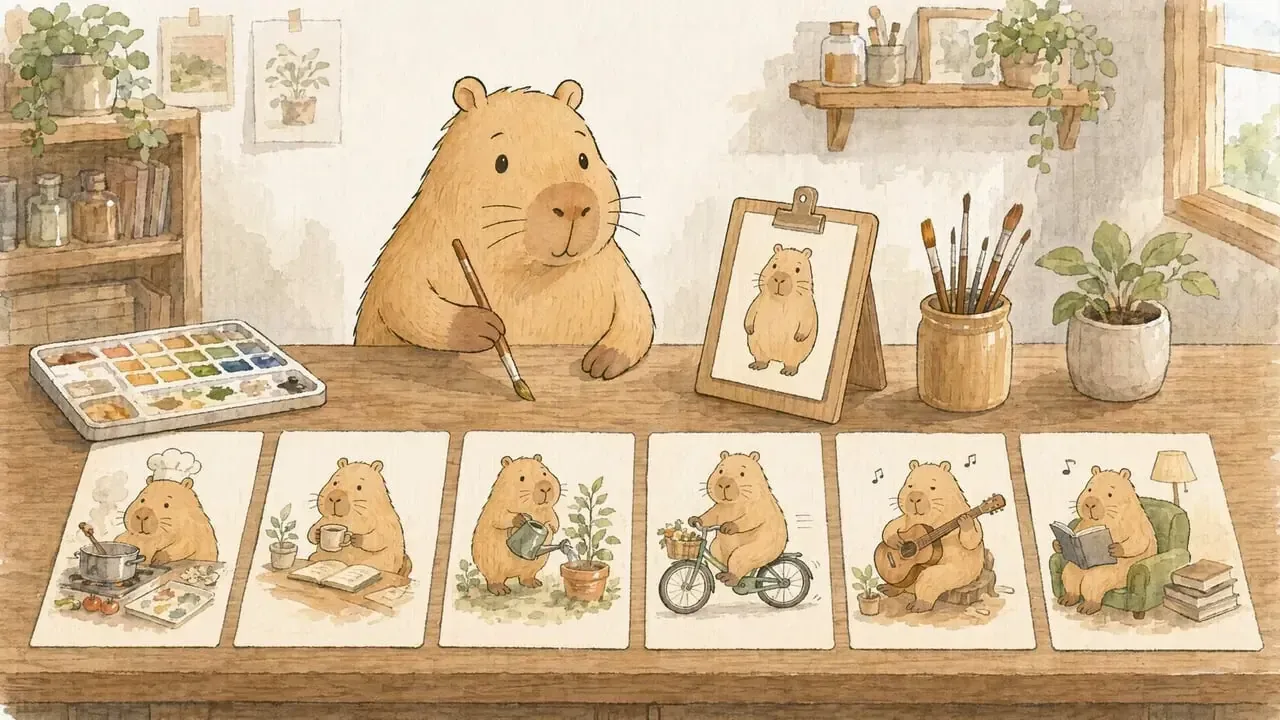
我们不这么干。在我们的流水线里,配图是第四个独立工位,和写作、核查同等重要。每篇文章 6 张图,不是随便找的,是专门设计的。每张图对应文章里的一个核心概念,用卡皮巴拉的视角把那个概念可视化。
为什么这么重视配图?因为读者的第一接触点不是文字,是图片。
在社交媒体上,用户刷信息流的速度极快——一条内容从出现在屏幕上到被划走,平均不到两秒。这两秒里,图片是唯一能抓住注意力的东西。文字需要读,图片一眼就能看懂。如果图片不能在两秒内传达「这篇文章讲什么」以及「值得点开看」,读者就划走了。
但配图最大的坑不是「好不好看」,是「风格不统一」。第一篇文章用了卡皮巴拉厨房风格,第二篇突然变成了赛博朋克风格,读者会觉得这不是同一个人写的。风格断裂比没有图更糟——它传递的信号是「这人不专业」。
我们的解决方案:所有文章的配图都用同一张基准图做参考。AI 生成图片时,如果给它一张参考图,它会模仿那张图的画风。我们第一篇文章的配图定下来之后,后续每一篇都用那张图的风格做基准。9 篇文章,54 张配图,全部是同一个卡皮巴拉世界——读者一眼就能认出「这是那个系列」。
这不是「给文章配几张图」。这是用视觉语言建立品牌识别度。和文字一样,配图也是一条需要设计、需要执行、需要统一标准的生产线。
质量门禁:一次性生成为什么靠不住
现在说回最关键的问题:为什么要搞这么复杂的流水线?一次性生成到底差在哪?
答案就两个字:门禁。
一次性生成的问题在于没有检查点。AI 写完就是终稿,你按了发送键,所有错误——编造的数据、不准确的引用、错误的因果关系——全部直达读者。你可能会说「我会自己读一遍」。但问题是,你读一遍能发现多少错误?
我们的 SDD 系列第七篇,写完之后跑了一次系统性的信息核查。核查发现了什么?
文章里说 Faros AI 的报告「追踪了九个月的数据」——核查后发现实际是八个月。文章里说这是「纵向追踪」——核查后发现实际上是「独立横截面」研究(翻译成人话:不是同一批人被追踪了八个月,而是在两个不同时间点各做了一次独立调查,两份报告之间隔了八个月)。文章里说两组数据「直接对冲」——核查后改为「形成张力」(因为两个数据测的东西不完全一样,不能简单说谁对谁错)。
这些错误,你「读一遍」的时候能发现吗?大概率不能。因为它们不是「一看就知道错了」的问题——它们是「看起来合理但实际上不够精确」的问题。AI 写的「追踪了九个月的数据」读起来完全通顺,逻辑也说得通。但事实是八个月。你不查,读者也不查,但万一有读者较真去翻了原始报告,你的可信度就没了。
这就是为什么需要第五工位——信息核查。而且核查不是「全部检查」,是分诊的。
LoudScale 2026 年的一篇方法论文章提出了一个「分诊核查」的概念——翻译成人话就是「不是所有内容都需要同等力度的检查」。来自学术论文的数据(经过同行评审的)快速过一遍就行;来自个人博客的数据(谁都能写的)要重点查。这样核查效率高,不会在可靠来源上浪费时间,把精力集中在最可能出错的地方。
但分诊只是第一步。2026 年行业实践的一个共识是:最强的核查不依赖单一检查器。SuccessTechServices 的工具对比报告指出——最好的工作流是 AI 核查工具 + 源检索(回到原始出处核实)+ 引用审查 + 人工编辑判断的组合。翻译成人话:不是让一个工具包打天下,是用多种方法交叉验证。
还有一个更深的问题:单个事实正确,不等于整体正确。TrySight 2026 年的方法指南提出了「结构性验证」的概念——一篇文章里每个数据单独看都没错,但它们组合在一起传达的整体框架可能是误导性的。比如你引了三个都说「AI 让编码变快」的数据,但故意忽略了三个说「AI 让交付变慢」的数据——每个事实都对,但整体是片面的。结构性验证就是检查这种「局部正确、整体偏差」的问题。
这里还有一个容易踩的坑:用 AI 核查 AI 的产出。Dachary Carey 2026 年的实践复盘指出,AI 评审自己的输出时存在系统性偏差——一是「自归因偏差」,模型评审自己家族的产出时倾向于给高分;二是「同族偏差」,比如 GPT 系列的模型偏好 GPT 家族的输出。翻译成人话:让 GPT 核查 GPT 写的文章,它会觉得「写得不错」。解决方案是用不同的模型核查、引用外部来源验证、人工做最终判断。
我们的核查流程结合了这三个层面:分诊(优先查低可靠性来源)+ 多层验证(AI 工具 + 源检索 + 人工判断,且核查用的模型和写作用的不是同一个)+ 结构性检查(看整体框架是否片面)。第七篇核查后从 3 条参考文献扩展到 10 条,第八篇修复了 5 个问题。这些问题如果不修,文章照样通顺、照样好看——但经不起较真的读者拿去验证。
一句话:管线和一次性生成的区别,不是产出的文章好不好看,是产出能不能经得起检验。 管线的每一步都是一道门禁,错误在中间被拦截,而不是一路传播到读者面前。
把流水线装进脑子里
回到开头的问题:AI 写作到底是魔法棒还是流水线?
答案取决于你要什么质量的产出。
如果你要的是「看起来像篇文章的东西」——通顺、有结构、没什么明显错误——那魔法棒够用了。打开 ChatGPT,说一句话,复制粘贴,三分钟搞定。
如果你要的是「经得起验证的文章」——每个数据有来源,每个论点有证据,每个断言都被检查过——那就得用流水线。六道工序,每一步可检验、可修复、可复现。
我们的 9 篇文章,每一篇都走完了这六道工序。不是每一篇都在每一步发现问题,但每一步都在那里等着。就像汽车工厂的质检站——不是每辆车都有问题,但每辆车都要过那一关。你不会因为「上次没发现问题」就跳过质检。
这六道工序也不是说你要花很多时间。熟练之后,一篇 3,000-5,000 字的文章从检索到发布,整个流程大约两到三个小时。和「打开 ChatGPT 写完直接发」相比,多了两个小时。但这两个小时换来的是:10 条可验证的参考文献、6 张统一风格的配图、所有断言经过逐条核查。
把 AI 写作当成流水线而不是魔法棒——每一步都可检验、可修复、可复现。 这不是效率的妥协,是质量的投资。
参考文献
-
Stanford HAI. (2026). The 2026 AI Index Report. 26 个前沿模型在用户暗示错误信念场景下的附和率 22%-94%。423 页年度报告。https://hai.stanford.edu/ai-index/2026-ai-index-report/responsible-ai
-
LoudScale. (2026). How to Fact-Check AI Content Before Publishing. 分诊核查系统:按来源可靠性分配核查力度,不是所有内容都需要同等检查。2026 年律所提交虚构案例引用被 NYT 报道。https://loudscale.com/blog/fact-check-ai-content-before-publishing/
-
SuccessTechServices. (2026). AI Fact Checking Tools: Best Options For 2026. 最强核查工作流 = AI 核查工具 + 源检索 + 引用审查 + 人工编辑判断。引用生成器不是事实检查器。https://www.successtechservices.com/ai-fact-checking-tools/
-
TrySight. (2026). Fact Checking AI Generated Content: A 2026 Guide. 单个事实正确≠整体正确。多 Agent 内容系统需要结构性逻辑审查。核查清单应内嵌发布流程。https://www.trysight.ai/blog/fact-checking-ai-generated-content
-
Dachary Carey. (2026). The Verification Gap in AI Content Pipelines. LLM-as-judge 的自归因偏差(模型评审自己的输出时系统性给高分)和同族偏差(GPT-4o 偏好 GPT 家族输出)。需要异构验证。https://dacharycarey.com/2026/03/29/ai-content-pipelines-verification-gap/
-
digitalapplied.com. (2026). AI Hallucination Rate Benchmarks 2026: 5-Model Study. 5,000 道题 × 5 个最新模型。开启「深度思考」模式后编造率减半(GPT-5.5: 8.3%→4.2%)。最好与最差模型差距 3 倍。https://www.digitalapplied.com/blog/ai-model-hallucination-rate-benchmarks-2026-study
-
SDD 博客系列项目(自有数据). 43 篇文献 → 9 篇文章 × 6 张配图 → 2 次信息核查修复 10+ 问题 → 第七篇核查后参考文献从 3 条扩展到 10 条 → 第八篇修复 5 个问题。YouMind Board: 019f1b5d-b7af-76c6-af5b-70415b13bcce