#4 当 Agent 失忆时——文档如何成为 AI 的外部记忆系统
📌 本文是「AI 时代的编码新范式」系列的第 4 篇。全系列共 9 篇,基于 43 篇行业文献、学术论文与一线实践报告,探讨 Spec-Driven Development 如何在 AI Agent 时代从边缘实践变为工程的基础设施。每篇可独立阅读。第 3 篇用数据证明了「AI 快不快取决于任务有多结构化」;本篇讲的是:让任务变得结构化之后,还有一个更底层的问题没解决——Agent 根本记不住上一轮发生了什么。
你已经让 Agent 跑了两个小时。上下文窗口快满了,响应越来越慢,你不得不重启会话。
重启后,你对 Agent 说「继续」。
Agent 沉默了几秒,然后开始重新理解项目。它重新读了目录结构。它重新翻了最近几个文件的 git log。它尝试推断「上一轮做到哪了」——但推理基于的是代码的当前状态,不是刚才那一小时的决策过程。有些判断它猜对了,有些它完全搞错了方向。它花了二十分钟重新走了一遍你已经走过的路,然后才勉强接上。
你不是在跟一个助手合作。你是在跟一个每次见面都要重新自我介绍的人合作。
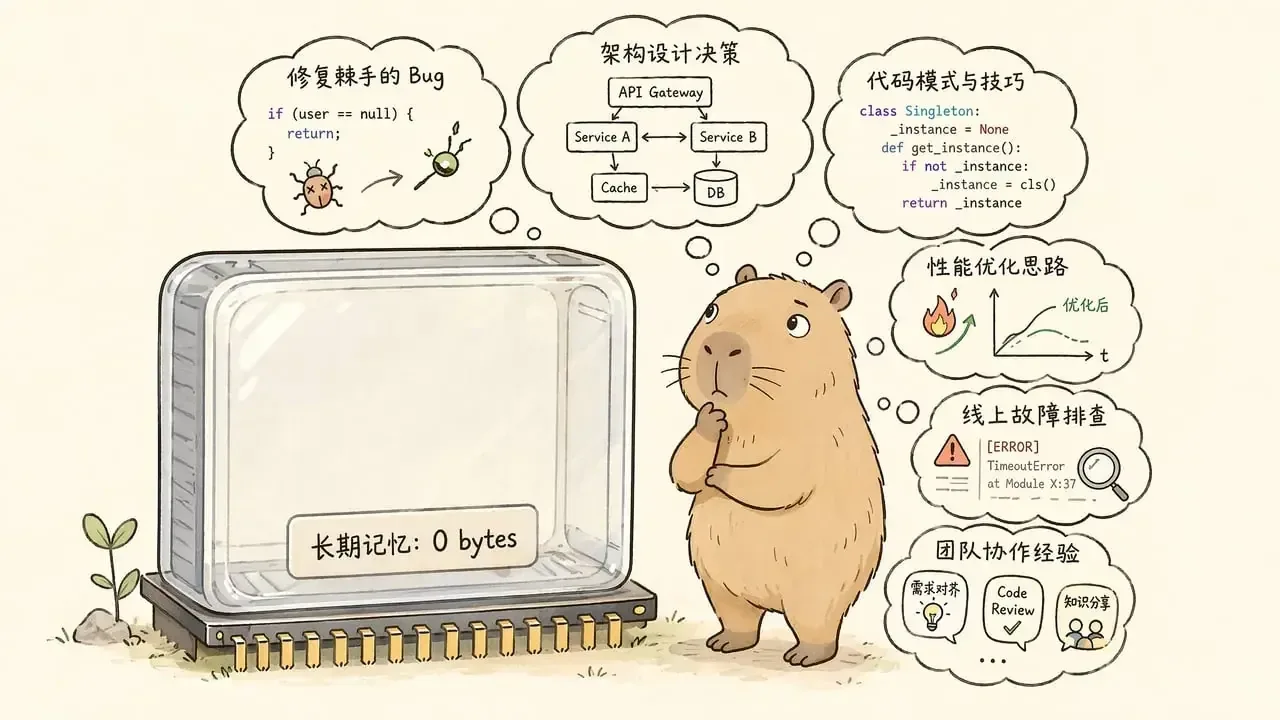
这是 Agent 编码最被低估的问题。不是模型不够聪明——Claude Opus 4.8 和 GPT-5 已经聪明到能独立完成小时级任务了。不是上下文窗口不够大——200K token 够装下一整本小说了。是架构问题:Agent 没有长期记忆。 每一次会话重启,对它来说就是世界重置。
而文档,恰好是解决这个问题的唯一手段。
被忽略的架构赤字
「Agent 没有长期记忆」这句话听起来像是一个已知的局限性,但它的工程后果远比大多数人意识到的严重。
人类工程师切换任务时,脑子里带着几十样东西。他知道昨天修的那个 bug 改动了三个文件,知道重构进行到一半卡在了测试用例上,知道上次开会讨论决定暂缓某个功能的实现但保留接口预留。他不需要重新翻阅整本代码库来找回这些上下文——它们在他的记忆里,随时可用。
Agent 不是这样的。
Agent 每次新会话启动时,手里只有三样东西:系统提示词、项目根目录下的配置文件(如果写了的话),以及它能读取到的文件内容。昨天下班前它花了四十分钟才搞清楚的那个架构决策?不在任何文件里。两小时前它发现用方案 A 会破坏模块 B 的兼容性所以改用方案 C?除非有人在当时把它写进了文档,否则这条推理链彻底消失了。
Anthropic 的工程团队在开发长程 Agent harness 时,用了一个精确的类比来描述这个问题:「想象一个软件项目由轮班工程师负责,每个新工程师到达时对上一班的任何事都没有记忆。」不是「记不太清」——是零记忆。每一班都从零开始。
这或许也能解释 METR 实验里那些经验丰富的开发者在用 AI 时反而慢了 19%:那些「隐式上下文」不仅包括代码风格和 linting 惯例——还可能包括 Agent 自己在几分钟前刚刚形成的理解。当 Agent 的短期推理无法持久化时,每一次上下文窗口刷新都是一次潜在的理解丧失。人类开发者可以凭记忆跨会话推进任务;Agent 不能。
这个问题有解吗?Anthropic 的答案是:把 Agent 的每一次思考都写进文件里。 不是「写一份详细的需求文档」那种写——是让 Agent 自己写。把文档变成 Agent 的外部硬盘。
Anthropic 的 harness:把文档变成 Agent 的记忆层
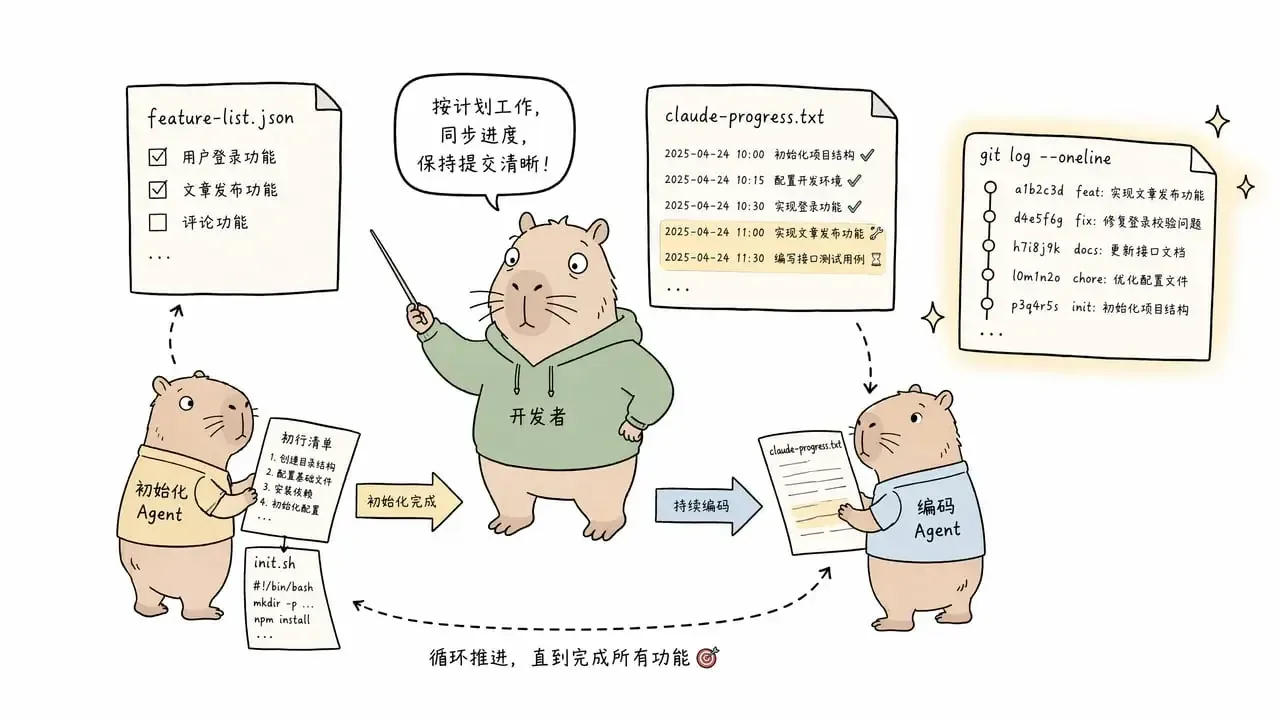
2025 年末,Anthropic 的工程团队公开了一套长程 Agent 的实践方案,核心思路出奇地简单:用两个 Agent、三份文件,搭出一个跨会话的记忆系统。
第一步:初始化 Agent。 接到一个高层次的任务——比如「做一个 claude.ai 的克隆版」——第一件事不是写代码,是让一个专门的初始化 Agent 搭建整个环境。它做了三件事:把用户的高层意图扩展成一份详细的功能清单(claude.ai 克隆版被拆成了超过 200 条端到端功能描述——「用户可以打开新聊天」「用户可以输入查询」「用户按回车后看到 AI 回复」),每一条都标记为「未通过」;写一个 init.sh 脚本,让后续任何 Agent 都能一键启动开发服务器;做一次初始 git commit,为后续的增量提交建立一个清晰的起点。
第二步:编码 Agent。 初始化完成后,每一次新会话启动一个编码 Agent。这个 Agent 启动时做的第一件事不是写代码,是阅读。它读 claude-progress.txt 了解上一轮做到了哪。它读 git log 了解最近的改动。它读功能清单文件,挑一条还没通过的功能,开始干活。做完之后,它写 git commit,更新进度文件,然后结束会话——把环境留给下一个 Agent。
这里的核心设计原则是:每一个 Agent 离开时,代码库必须处于一个「干净」的状态。 没有半成品。没有未记录的决策。没有「我也不知道这段代码是干嘛的但没它就会崩」的神秘补丁。每一次会话结束时,代码库的状态应该可以直接合并到主分支——不是因为每次产出都完美,是因为每次产出都是完整、可理解、可继续的状态。
这套流程解决了长程 Agent 的四个经典失败模式:
-
一步到位综合征:Agent 试图一次性实现所有功能,上下文窗口中途爆掉,留下半实现的特性。解法:功能清单文件把大目标拆成小步骤,每次只做一个。
-
过早宣布胜利:Agent 看到代码库里有进展就认为任务完成了。解法:功能清单里每一条都标记了通过/未通过状态,Agent 只有把所有条目都改成了「通过」才算完。
-
自欺欺人的测试:Agent 改了代码、跑了单元测试、就标记为完成——但端到端根本不 work。解法:显式要求 Agent 用浏览器自动化工具像真实用户一样操作一遍,截图验证。
-
启动时的方向迷失:每个新 Agent 都要花大量时间猜「现在是什么情况」。解法:三行标准启动步骤——
pwd确认工作目录 → 读 git log 和进度文件 → 从功能清单里选下一个任务。
当这套机制跑起来之后,一个典型 Agent 会话的启动消息看起来是这样的:先执行 pwd,确认自己在正确的目录里;然后读 claude-progress.txt,看上一轮做了什么、卡在哪里;然后跑 init.sh 启动开发服务器,用浏览器自动化跑一遍基础端到端测试确认 app 还活着;然后打开功能清单文件,选最高优先级、还没通过的那一条,开始干活。
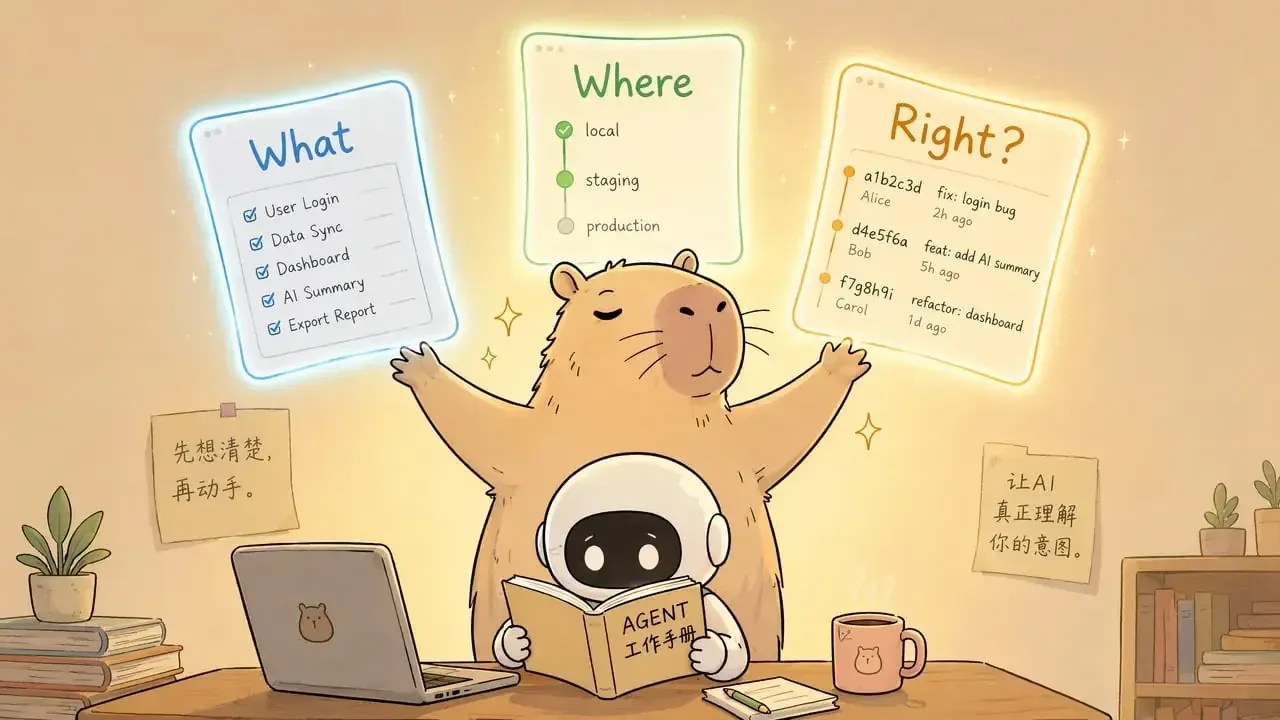
三份文件撑起了这整个过程:功能清单(What)→ 进度文件(Where)→ git log(Right?)。三层各司其职。Agent 不靠「记住」来推进——它靠「读」来推进。
这不是 Anthropic 独有的——这是 Agent 编码的生存本能
Anthropic 的 harness 方案看起来像是为超长任务设计的特殊工具。但实际上,任何让 Agent 工作超过一个会话的开发者都会自发地走向同样的模式。
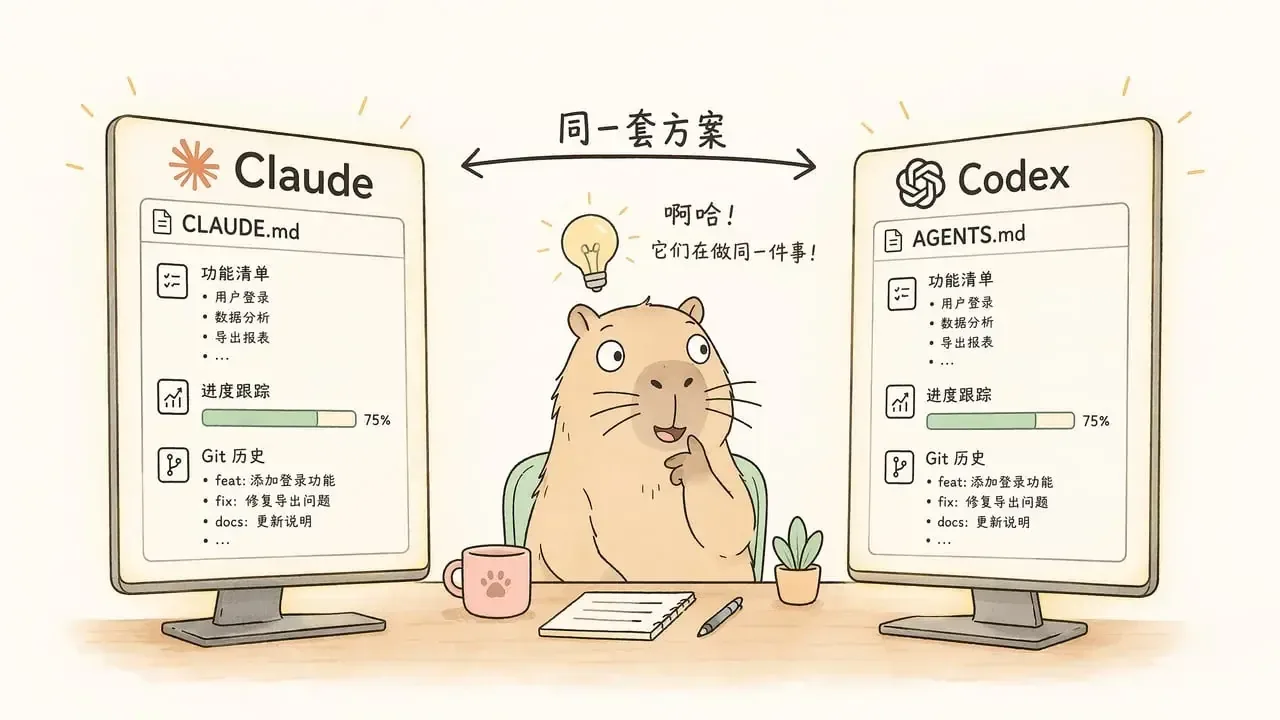
OpenAI 的 Codex 团队在零行手写代码的实验里,建了几乎一模一样的机制:execution plan 是他们的功能清单,带进度日志和决策日志、签入仓库;「文档园艺」Agent 定期扫描过时文档、自动提修 PR;整个 docs/ 目录就是 Agent 的持久化知识库。他们管核心设计理念叫「progressive disclosure」——Agent 启动时看到的是一百行的目录,而不是一千页的手册。Agent 被教会在需要的时候自己去翻更深层的文档。
两个团队——一个做 Claude,一个做 Codex,做不同的事——得出了完全相同的结论:Agent 的工作质量不取决于你给它的初始 prompt 有多聪明,取决于你给它的文档系统有多完整。 不是「写一份好文档让 Agent 理解需求」——那个层面的问题第 1 篇已经讲过了。这里讲的是更深一层:「写一套文档系统让 Agent 理解自己的状态。」
Anthropic 在 Building Effective Agents 一文里给了一个更通用的判断框架。它把 Agent 系统分为两组:workflow(流程固定的、可预测的任务)和 agent(需要模型自己决策的、灵活的、开放式的任务)。当一个任务可以用可自动化验证的标准来评估时,Agent 可以自己跑——auto-accept,不需要人盯着。当验证需要人类判断——「这个设计决策的风格对不对」「这个交互体验好不好」——就必须停下来等人工 review。
文档的角色就是定义这个边界。功能清单里的验收标准就是那个「可自动化验证」的锚点。如果一条验收标准是「用户可以发送消息并看到 AI 回复」——这个 Agent 可以用浏览器自动化自己验证。如果一条验收标准是「整体 UI 风格符合品牌指南」——这就不是 Agent 自己能判断的事。文档写清楚了每一条标准的性质,Agent 就知道什么时候该自己跑、什么时候该停下来等人。
这也解释了 Claude Code 的 Best Practices 文档里为什么第一条就是「给 Agent 一个验证自己工作的方式」。不是「写更好的 prompt」——虽然那也重要——是「让它能自己判断做对了没有」。测试用例是最直接的验证方式。截图对比是 UI 开发的验证方式。linting 结果是代码风格的验证方式。每一项验证标准都是一条「Agent 可以在不依赖人类判断的情况下推进」的许可。没有验证标准的任务,Agent 每走一步都要回头看你——而这恰好是把 Agent 用慢的方式。
你需要的不一定是 Anthropic 级别的 harness
读到这里,你可能会觉得这听起来像是为「团队用 Agent 做百万行代码级产品」设计的重型装备。Anthropic 那个 claude.ai 克隆版确实用了全套 harness——功能清单文件、进度文件、init.sh、浏览器自动化验证、专门的初始化和编码 Agent 分工。
但它的核心原则在任何一个单人项目里都适用,而且不需要 Anthropic 级别的工程投入。
你现在就可以做的事:在你的项目根目录下建一个 progress.md 文件。每次 Agent 完成一个任务后,让它自己往文件里追加三行:做了什么、改了什么文件、下一个任务是什么。下次你启动新会话时,Agent 读的第一样东西就是这个文件。
如果你想让 Agent 自己拆任务——在你描述一个较大的目标后,先不让它写代码,让它先写一份 plan.md:目标拆成几个步骤、每个步骤的验收标准是什么、依赖关系是什么。你花两分钟 review 一下这份计划——方向对就通过,方向不对就改——然后让 Agent 按着这个计划一条一条做。做完一条,检查一条,在计划文件里打勾,继续下一条。
这不是什么复杂的流程设计。这就是在弥补 Agent 的架构赤字——给它一个它自己能读懂的「我在哪、我要做什么、我做到了哪」的状态文件。
Claude Code 的 Plan Mode 本质上就是这件事的产品化版本:先探索、再规划、再编码。探索阶段 Agent 只读不改——理解代码库、分析需求、确认边界。规划阶段它输出一份执行计划供你审查。编码阶段它才开始改代码。三步的分界线就是文档:探索的产物是理解文档,规划的产物是执行计划,编码的输入是这两份文档的组合。
这个模式还有一个反直觉的好处:让 Agent 写文档本身就是在让 Agent 更好地理解任务。 当 Agent 被要求把一个模糊的高层目标拆成 200 条具体的功能描述时,它在这个过程中必然会遇到它不理解的地方——那些地方如果直接写代码就会变成 bug。但写文档是无损的:Agent 在文档里暴露了它的理解盲区,你修正文档,而不是修代码。在文档层解决一次理解偏差的成本,远低于在代码层解决同样一个偏差。
三份文件,三个角色
回到那三份文件。它们看起来只是普通的 Markdown 或 JSON 文件,但在 Agent 的工作流里,每一份都承担了一个人类工程师靠脑子完成的功能。
需求文档 / 功能清单解决的是「做什么」。它不是 PRD——不是写给产品经理看的。它是 Agent 的任务分解:目标被拆成了可独立执行、可独立验证的子单元。每一条子单元有明确的验收标准。Agent 不需要在任何时候「理解全局」——它只需要知道当前这一步的目标和验收标准。全局在文件里,不在 Agent 的上下文窗口里。
进度文件解决的是「做到了哪」。人类工程师切换任务时,哪怕只是去倒了杯咖啡,回来也知道「我刚改到第三个测试用例」。Agent 不知道。进度文件就是那个「我刚改到哪」——但不是给人看的,是给下一个 Agent 会话看的。它不追求可读性。它追求精确性:改了什么文件、通过了哪些测试、下一个待处理的任务是什么。
**git log **解决的是「做对了没」。如果你让 Agent 每完成一个子任务就做一次有意义的 git commit——不是「update」那种——那么任何一个后续的 Agent 都可以通过读 commit history 来理解「这段代码是为什么加进来的」「那次重构改了什么」。更重要的是,如果某个改动引入了问题,Agent 可以用 git revert 自己回滚到上一个干净状态,重新开始。这不是备份——这是 Agent 的安全网。
这三层合在一起,就是 Agent 的外部记忆系统。它不是给人看的历史记录。它是 Agent 的工作内存的持久化层。当 Agent 读这些文件时,它不是在「参考文档」——它是在「加载状态」。就像你打开一个游戏时读取存档文件。你不需要记住上一次你在哪个关卡、装备了什么、血量剩多少——存档文件替你记住了。文档对 Agent 而言,就是存档文件。
下次重启会话之前
Agent 没有长期记忆这件事,在 2026 年不会改变。上下文窗口在变大——200K、500K、1M——但本质上仍然是同一个架构:一次会话结束,上下文全部丢弃。更大的窗口只是让 Agent 能在同一轮里跑得更久,不改变它重启后失忆的事实。
但文档可以改变这件事。
不是「多写文档」——那种笼统的建议没有用。是写三样东西:一份说清楚做什么的清单,一份说清楚做到了哪的进度,一份记录了每一步决策的 git log。不是为你写的。是为下一个 Agent 实例写的。你每次启动 Claude Code 时,让它先读这三样东西,再开始干活。
这不会让你慢下来。第一次启动确实多花了三分钟——Agent 在读文档而不是直接写代码。但从第二次启动开始,你省下的是 Agent 重新理解项目、重新推断上一轮决策、重新试探「方向对不对」的全部时间。这些时间的总和,远远超过那三分钟。
这不是方法论。这是基础设施。就像你不会让一个没有文件系统的操作系统运行程序一样,你也不应该让一个没有外部记忆的 Agent 跨会话执行任务。文档不是 Agent 的使用说明书——文档是 Agent 的操作系统。
参考文献
-
Anthropic. (2025, 推测). Effective Harnesses for Long-Running Agents. Anthropic Engineering Blog. Two-agent system: initializer + coding agent, feature list file, progress file, and git-based state tracking for cross-session continuity.
-
Anthropic. (2024). Building Effective Agents. Anthropic Research. Agentic system patterns (workflow vs agent), autonomy boundary framework, and the principle of starting simple.
-
Anthropic. (2025, 推测). Claude Code: Best Practices for Agentic Coding. Claude Code Documentation. CLAUDE.md configuration, explore→plan→code workflow, verification criteria, and context window management.
-
OpenAI. (2026, 推测). Harness Engineering: Leveraging Codex in an Agent-First World. OpenAI Engineering Blog. Progressive disclosure, execution plans as first-class artifacts, and doc-gardening agents for maintaining the agent knowledge base.
-
METR. (2025). Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity. Randomized controlled trial: AI use resulted in 19% slower completion in mature open-source projects, partly due to implicit context losses across coding sessions.