LLM 项目级代码审计能力现状评估
目的:澄清 2026 年 4 月 LLM + AI 编码工具在项目级代码(50 万行 / 中度游戏规模)审计场景下的真实能力边界,为团队技术决策提供依据。
核心结论:LLM 在局部辅助开发上已经非常好用,但在全局代码审计上目前没有成熟方案。两者是本质不同的任务,不应混淆。
一、概念对齐:辅助开发与代码审计的本质差异
在评估 LLM 的代码能力之前,我们必须先澄清一个常见的认知误区:辅助开发和代码审计是两个完全不同的任务,对模型的要求有着本质区别。
辅助开发场景中,开发者已经明确知道要做什么——修复一个已知的 bug、实现一个新功能、重构某个模块。模型的任务是理解当前任务涉及的 5-10 个文件,在开发者的引导下完成具体的代码变更。这是一个人在环路中、容错率高、范围可控的协作过程。
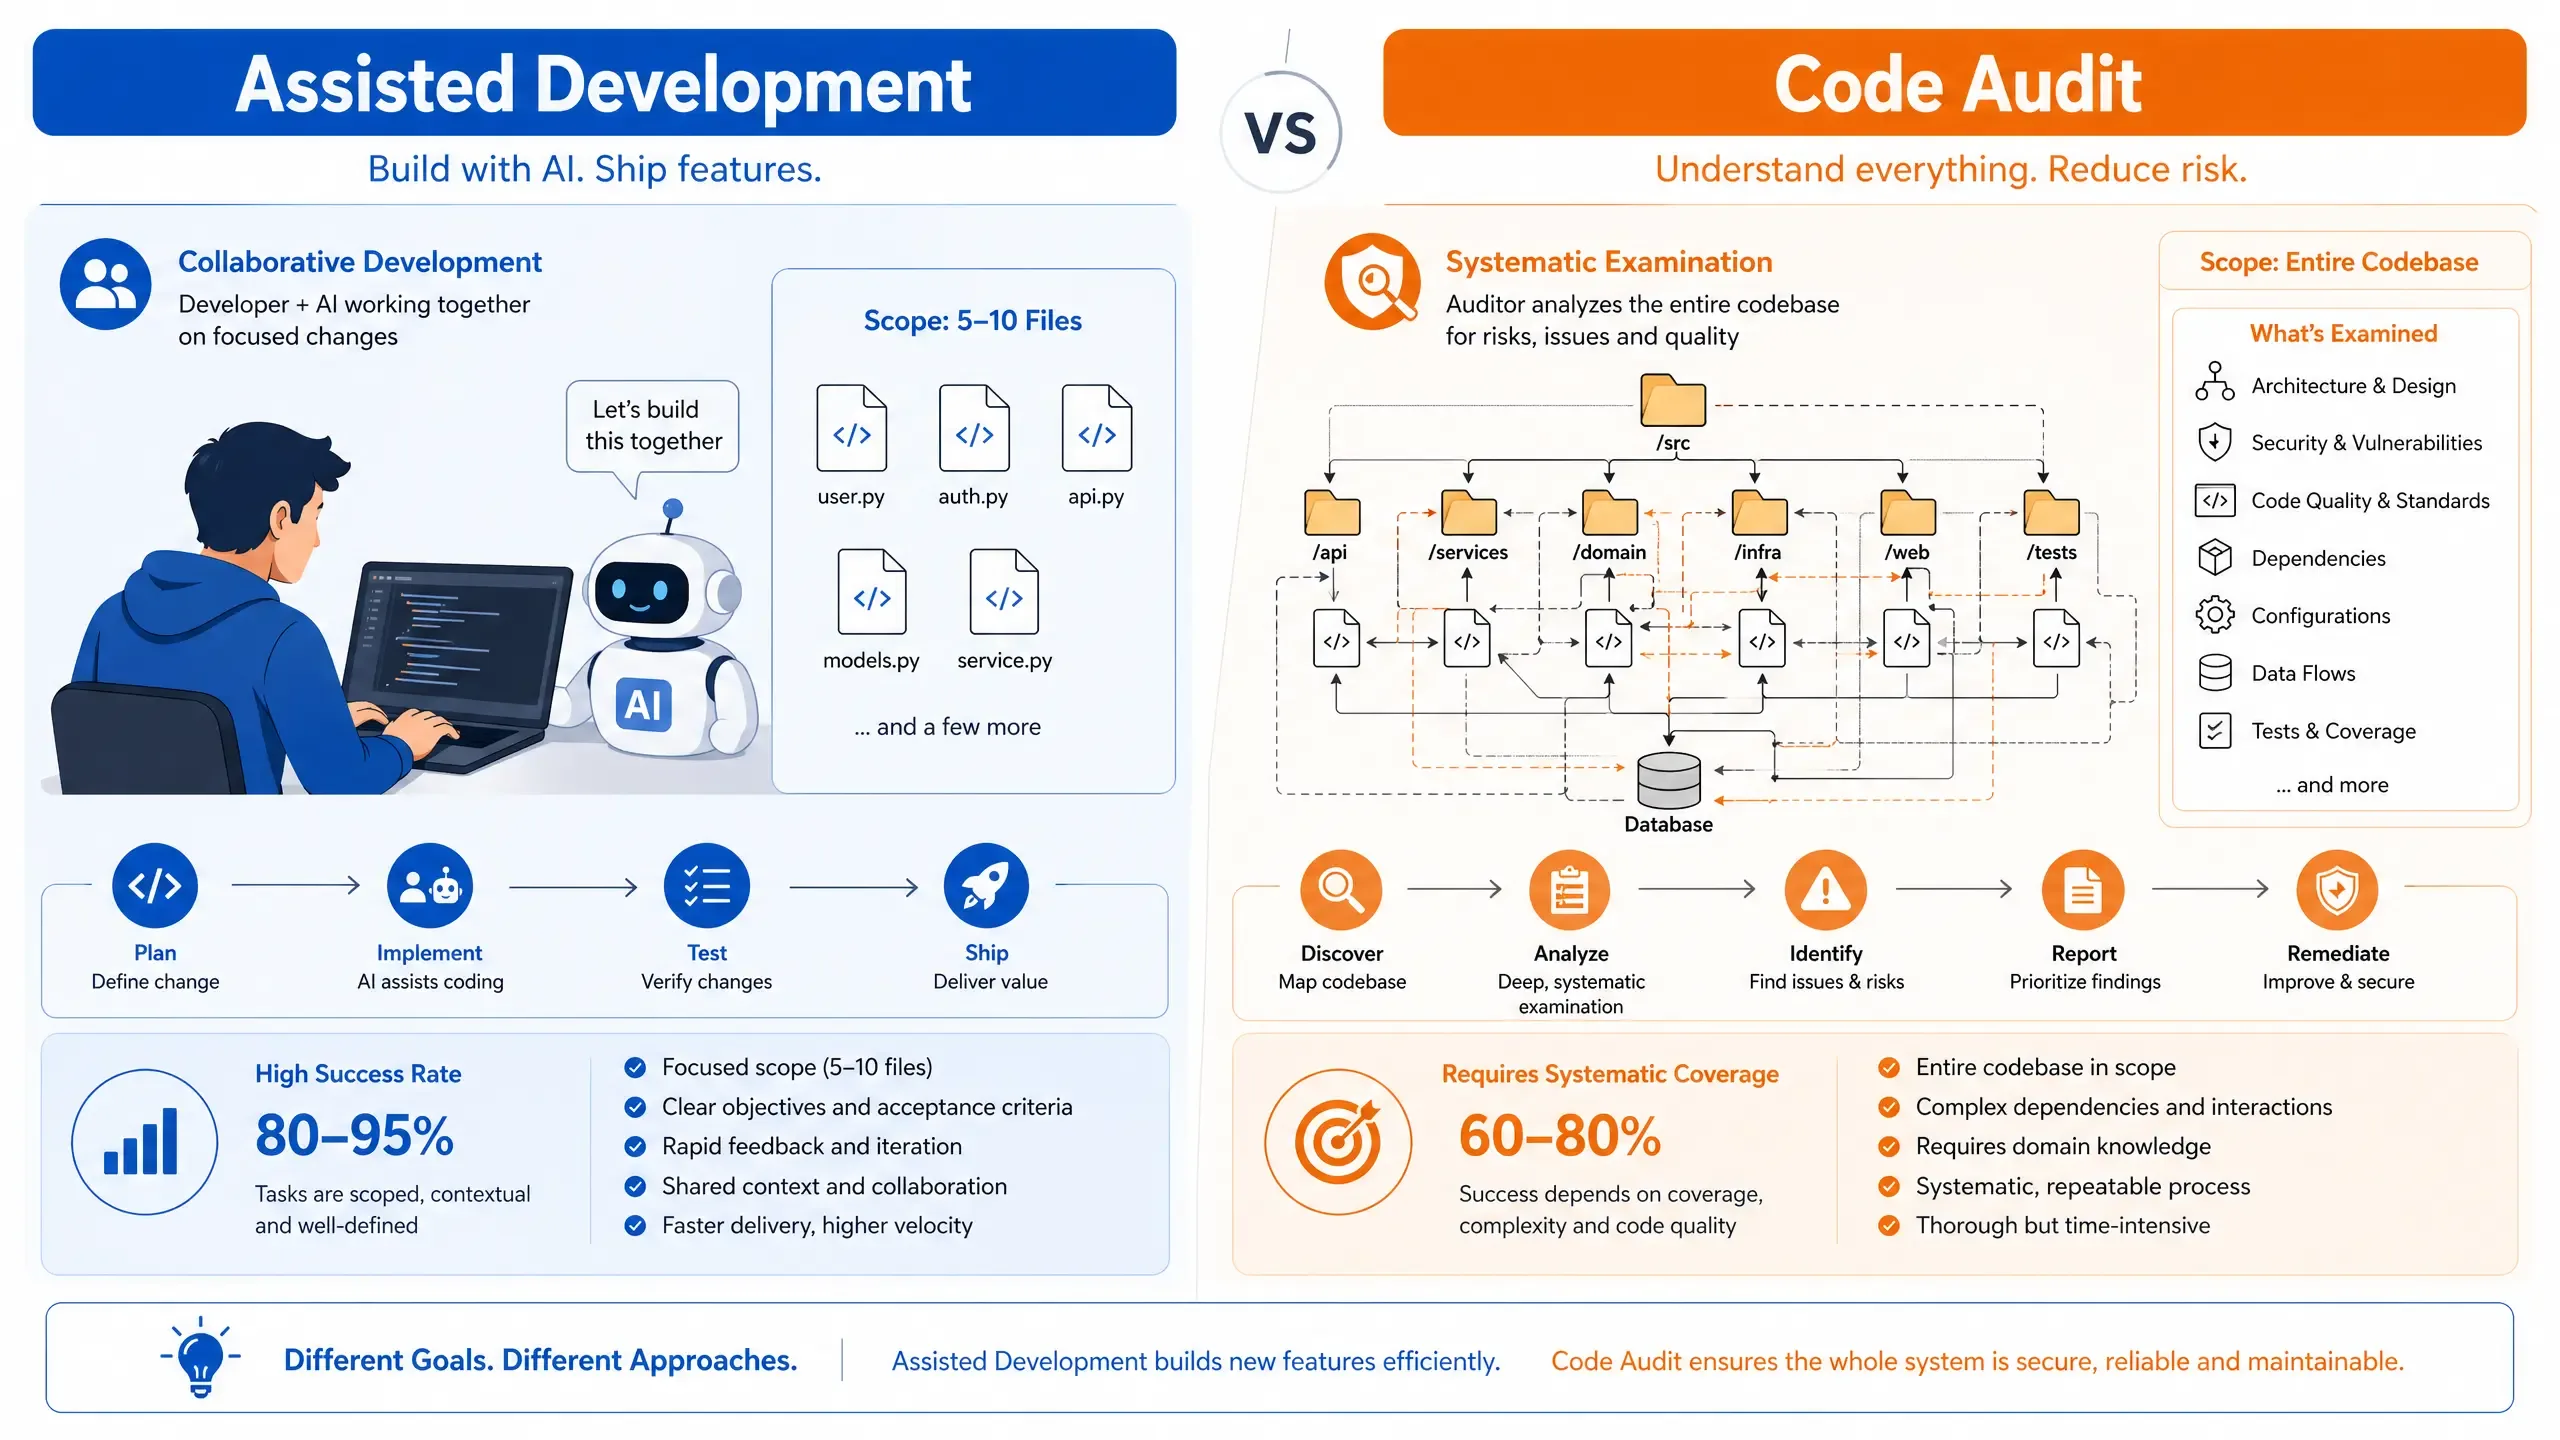
代码审计则完全不同。审计员面对的是一个完整的代码库,需要在没有明确问题描述的情况下,系统性地发现潜在缺陷——可能是架构设计层面的问题,可能是跨模块的隐含依赖,也可能是边界条件的遗漏。这要求对整个代码库建立全局理解,进行跨模块推理,并且不能有遗漏。容错率极低:漏审一个关键问题就意味着审计失败。
| 维度 | 辅助开发(已成熟) | 代码审计(未成熟) |
|---|---|---|
| 模型需要理解的范围 | 当前任务涉及的 5-10 个文件 | 整个代码库的全局架构和隐含关系 |
| 问题是否已知 | 是(开发者知道要做什么) | 否(需要模型自己发现问题) |
| 跨模块推理 | 偶尔需要,可人工引导 | 核心要求,必须自主完成 |
| 容错率 | 高(人在环,可随时纠正) | 低(漏审 = 审计失败) |
| 当前工具胜任度 | 高 | 低 |
市面上宣称“支持百万行代码库”的工具——Cursor、Augment、Sourcegraph Cody 等——解决的都是辅助开发问题。它们能索引百万行代码,让开发者在需要时检索到相关片段,但“索引”和“理解”是两回事。Sourcegraph 能索引 Google 的整个代码库,但没人会说它“理解”了 Google 的代码。这个区别至关重要。
二、结构性瓶颈:为什么 50 万行全局审计现在做不到
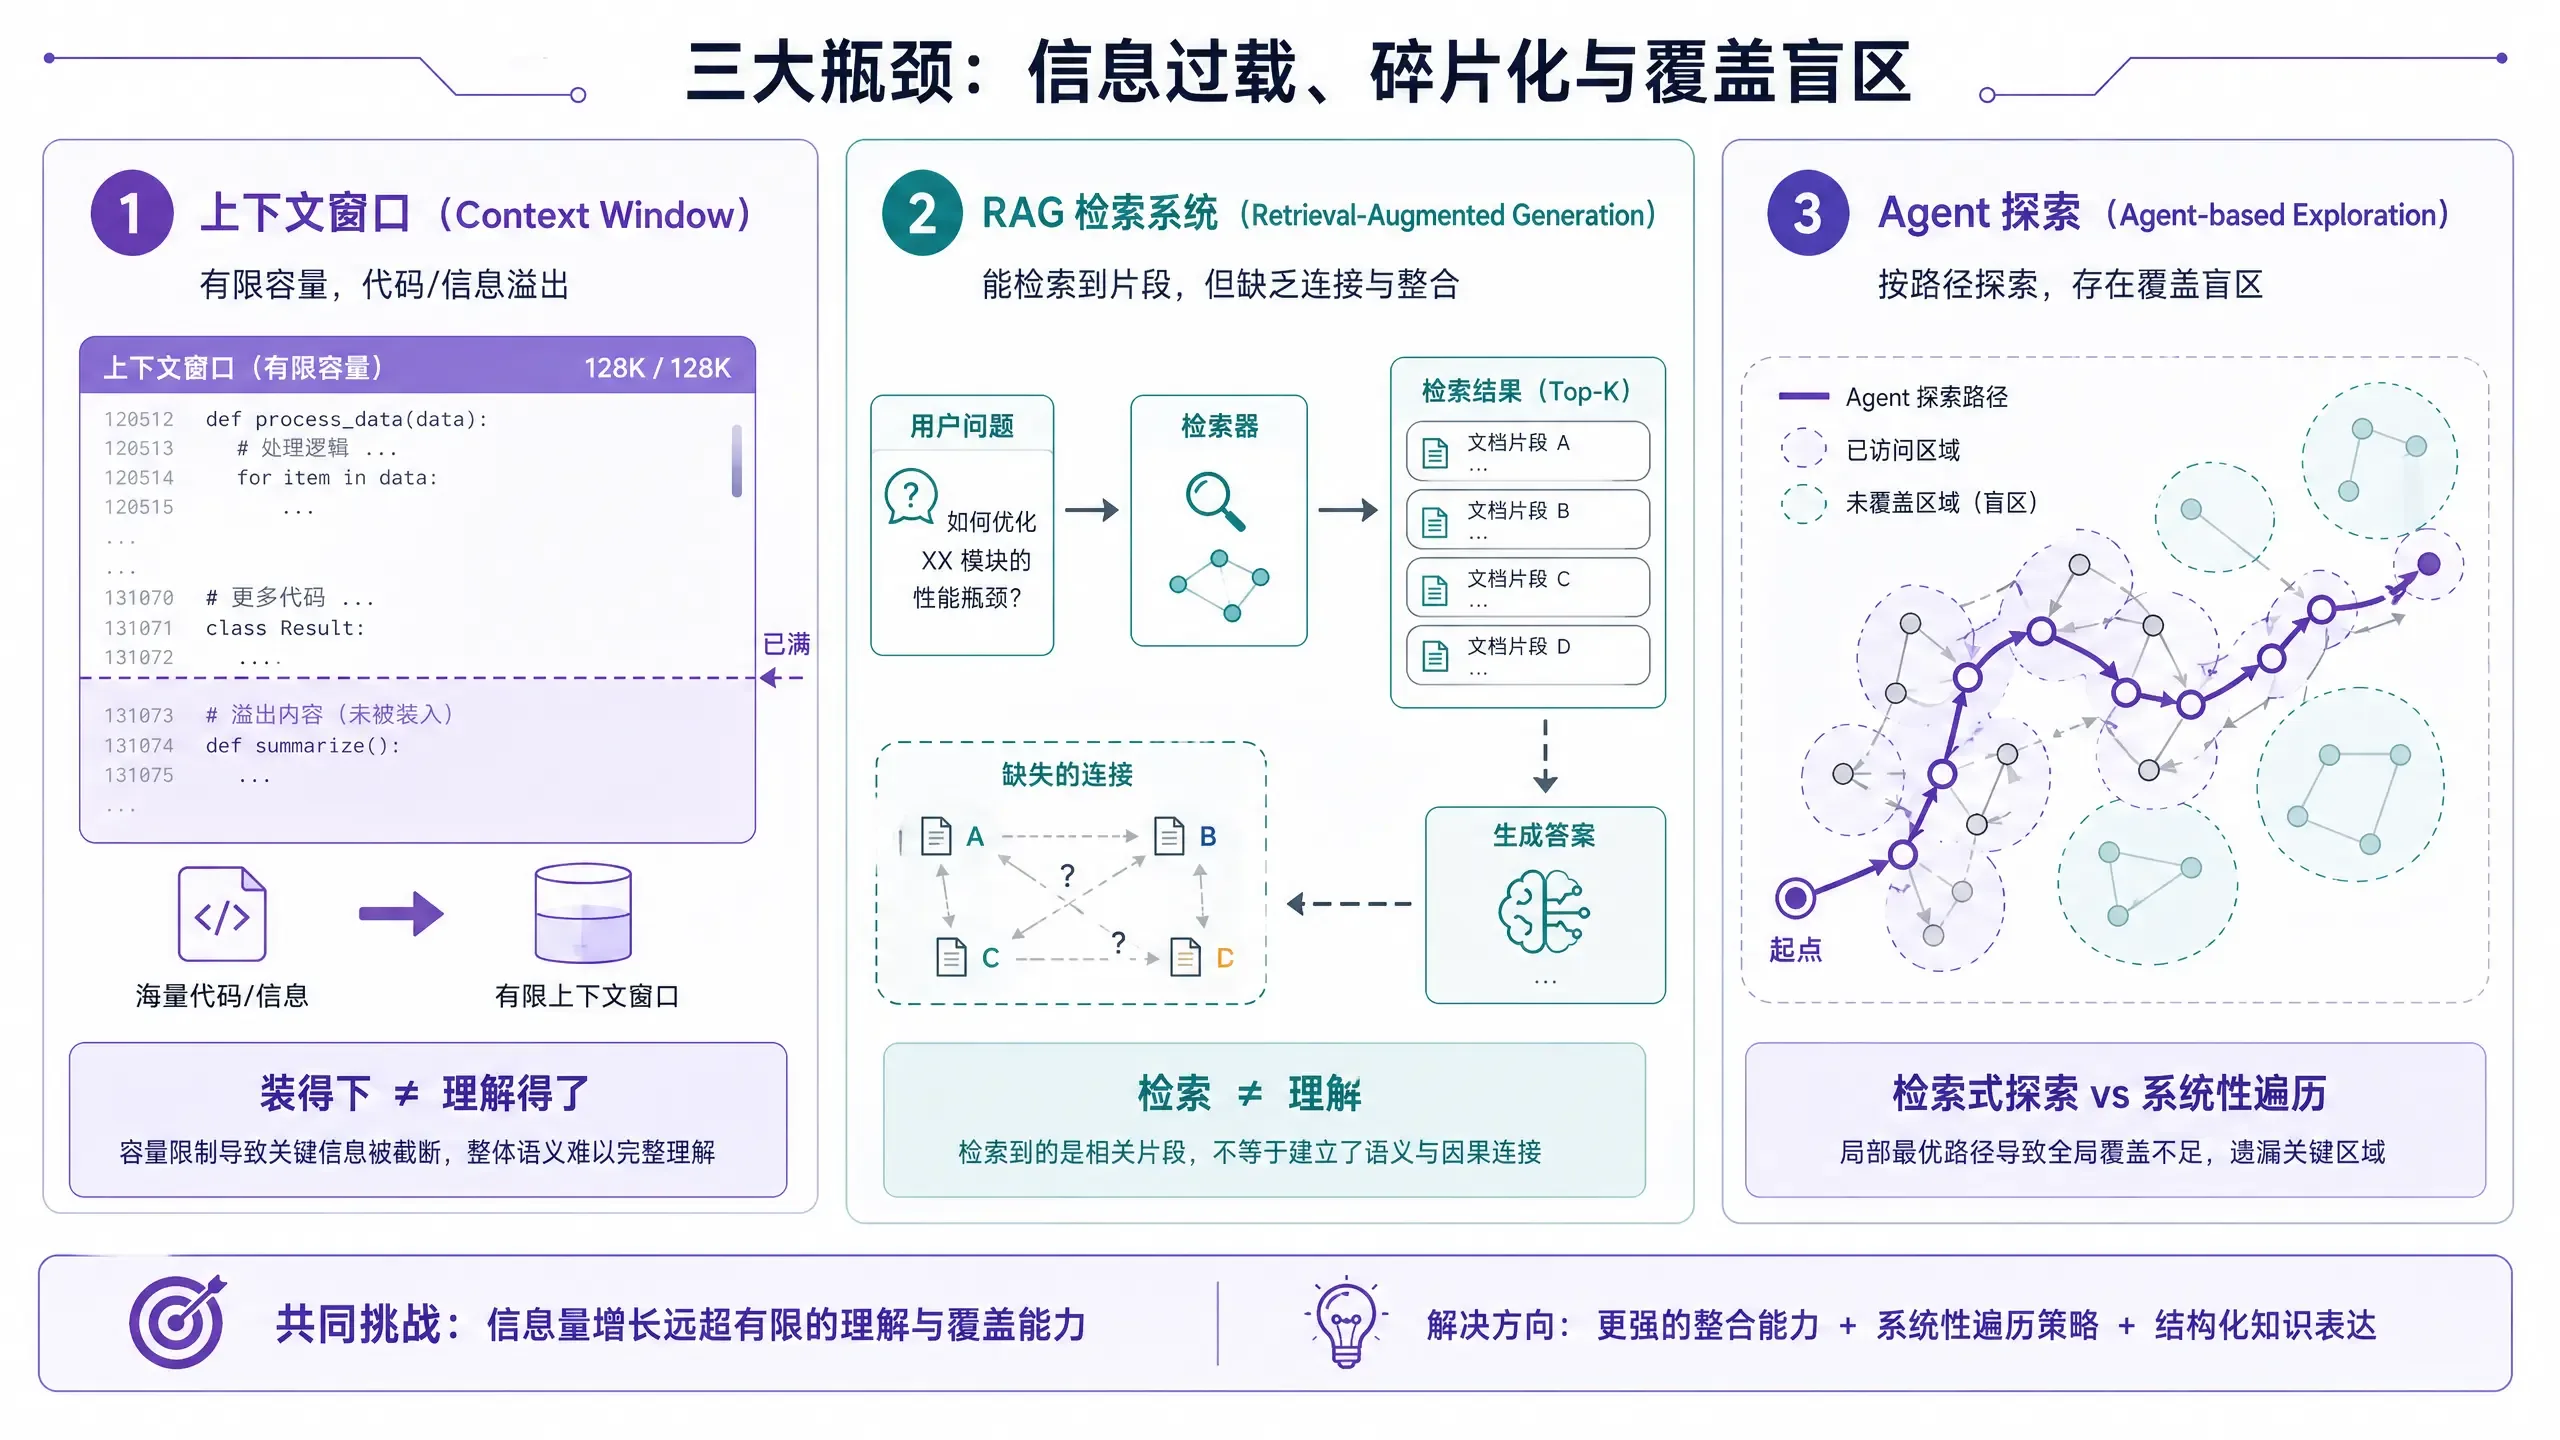
2.1 上下文窗口的悖论:装得下不等于理解得了
2026 年 4 月,主流模型的上下文窗口已经全面达到 1M tokens 级别。这是一个重要的技术突破:
| 模型 | 上下文窗口 | 发布/GA 时间 | 备注 |
|---|---|---|---|
| Claude Opus 4.7 | 1M tokens | 2026-04-16 GA | 标准定价 $5/$25 per MTok,无长上下文溢价 |
| Claude Opus 4.6 / Sonnet 4.6 | 1M tokens | 2026-03-13 GA(标准定价) | 此前 200K 以上有 2x 溢价,已取消 |
| Gemini 2.5 Pro | 1M tokens | 2025-06 GA | 200K 以上有 2x 溢价;2M 版本仍未 GA |
| Gemini 3 Pro | 1M tokens | 2026 | 默认 1M |
| GPT-5.4 | 1M tokens | 2026 | 超过 272K 有 2x 溢价 |
1M tokens 约等于 25-40 万行代码(取决于语言和注释密度)。理论上,50 万行代码已经接近能装进单次上下文了。然而,这恰恰让问题更加清晰——瓶颈不在“装不装得下”,而在“理解不理解得了”。
首先是 context rot(上下文衰减)问题依然严重。Claude Opus 4.6 在 1M token 的多针检索测试(MRCR v2,在 100 万 token 中隐藏 8 条关键信息并全部找到)中准确率为 76%——这意味着满载上下文中约 1/4 的关键信息会被遗漏。Sonnet 4.5 在同一测试中仅 18.5%。独立开发者的实战反馈更加直接:超过 700K tokens 后性能明显下降,很多人建议在 150K tokens 左右重启会话以保持质量。
更深层的问题在于:装入上下文不等于推理。人类审计员读 50 万行代码也不是靠“全部记住”,而是靠逐步构建心智模型——架构图、数据流图、状态机。这些心智模型是持久的、可更新的、结构化的。LLM 没有这样的持久工作记忆来构建和维护心智模型,每次对话都是从零开始。Opus 4.6/4.7 引入的 Compaction 机制(自动上下文压缩)能延长对话,但压缩过程中必然丢失细节,这对审计来说是致命的。
最后是成本现实。一次 900K token 的 Opus 4.7 请求仅输入就需约 $4.50(注:Opus 4.7 使用新 tokenizer,同样文本可能产生比 4.6 多 0-35% 的 token)。审计不是一次请求能完成的——需要反复对话、多角度验证,总成本快速累积。这使得即使技术上可行,经济上也难以持续。
2.2 RAG 的局限:检索不等于理解
把代码库向量化后做 RAG(检索增强生成),能解决“找到相关代码”的问题,但解决不了审计所需的核心能力:
状态追踪需要追踪一个变量从初始化到最终消费经过了 15 个函数、3 个模块的完整路径。这不是向量相似度能捕捉的——你需要理解每个函数的语义,理解数据如何在调用链中流动和转换。
隐含依赖发现要求判断两个看似不相关的模块是否通过事件系统、回调机制或全局状态产生了耦合。这种依赖关系往往不在代码的表面,而是隐藏在运行时行为中。向量检索能找到“提到相同关键词的代码”,但找不到“运行时会相互影响的代码”。
缺失检测是最难的:“模块 A 的重构导致模块 B 的一个边界条件不再被覆盖”——这需要同时理解两边的逻辑并做差异推理。你需要知道原本应该存在什么,才能发现现在缺失了什么。RAG 的本质是“给你找到可能相关的代码片段”,但审计需要的是“在所有代码的上下文中判断这段逻辑是否正确”。
Cognition(Devin 团队)的内部测量数据揭示了这个问题的严重性:其 coding agent 有 60% 的时间花在搜索和上下文检索上,而非代码生成。这说明即使是最先进的 agent 系统,“找到正确的代码”本身就是核心瓶颈。
2.3 Agentic 工作流:方向正确但远未成熟
当前最有前景的方向是 Agentic 模式——模型主动探索仓库、读文件、跑测试、验证、修改。Claude Code、Augment Agent 等都在走这条路。这比一次性投喂代码好得多,因为它允许模型按需获取信息,避免了上下文窗口的硬限制。
然而,距离“可靠审计”仍有很大差距。Agent 的探索是沿着检索路径走的,而审计需要系统性遍历。想象一个侦探调查案件:检索式探索就像“顺着线索追踪”,你能找到与线索相关的证据;系统性遍历则像“地毯式搜查”,你要确保没有遗漏任何角落。前者适合解决已知问题,后者才能发现未知问题。
Agent 没有全局地图,容易“只见树木不见森林”。它可能深入研究了某个模块的实现细节,却没有意识到这个模块与另一个模块的交互存在问题。更严重的是,多步推理中的错误会累积——每一步的小偏差在 10 步之后可能导致完全错误的结论,而 agent 缺乏自我纠错机制来检测这种累积偏差。
三、最硬的证据:基准测试数据(2026 年 4 月 26 日)
3.1 SWE-bench Pro:最接近真实项目级别的测试
SWE-bench Pro 由 Scale AI 于 2025 年底发布,包含 1,865 个任务,覆盖 41 个真实仓库(Python / Go / TypeScript / JavaScript),是目前最接近真实大型项目工程任务的基准。平均一个修复需要改 4.1 个文件、107 行代码——这已经是相当复杂的多文件变更了。
这个基准的重要性在于它的真实性。OpenAI 的内部审计发现,所有主流前沿模型(GPT-5.2、Claude Opus 4.5、Gemini 3 Flash)都能对 SWE-bench Verified 中的某些任务复现逐字的 gold patch,证明存在数据污染。OpenAI 已停止报告 Verified 分数并推荐使用 SWE-bench Pro。Pro 版本使用更新的、未被训练数据污染的真实问题,因此分数更能反映模型的真实能力。
SWE-bench Pro 最新成绩(2026 年 4 月,公开集 731 题):
| 排名 | 模型/Agent | SWE-bench Pro 得分 | 说明 |
|---|---|---|---|
| 1 | Claude Opus 4.7 | 64.3% | Anthropic 自报,2026-04 |
| 2 | GPT-5.4 (xHigh) | 59.1% | Scale SEAL mini-swe-agent |
| 3 | GPT-5.3-Codex (agent system) | 56.8% | OpenAI 自报 |
| 4 | Muse Spark (Meta) | 55.0% | Agent system |
| 5 | Claude Opus 4.6 | 51.9% | Scale SEAL mini-swe-agent |
| 6 | Augment Auggie CLI | 51.8% | Augment 自报,使用 Opus 4.5 底座 |
| 7 | Cursor | 50.2% | Agent system,使用 Opus 4.5 |
| 8 | Claude Code | 49.8% | Agent system,使用 Opus 4.5 |
| — | Scale SEAL 标准化基线(Opus 4.5) | 45.9% | 标准化 scaffold,消除 agent 架构差异 |
这些数字揭示了几个关键事实:
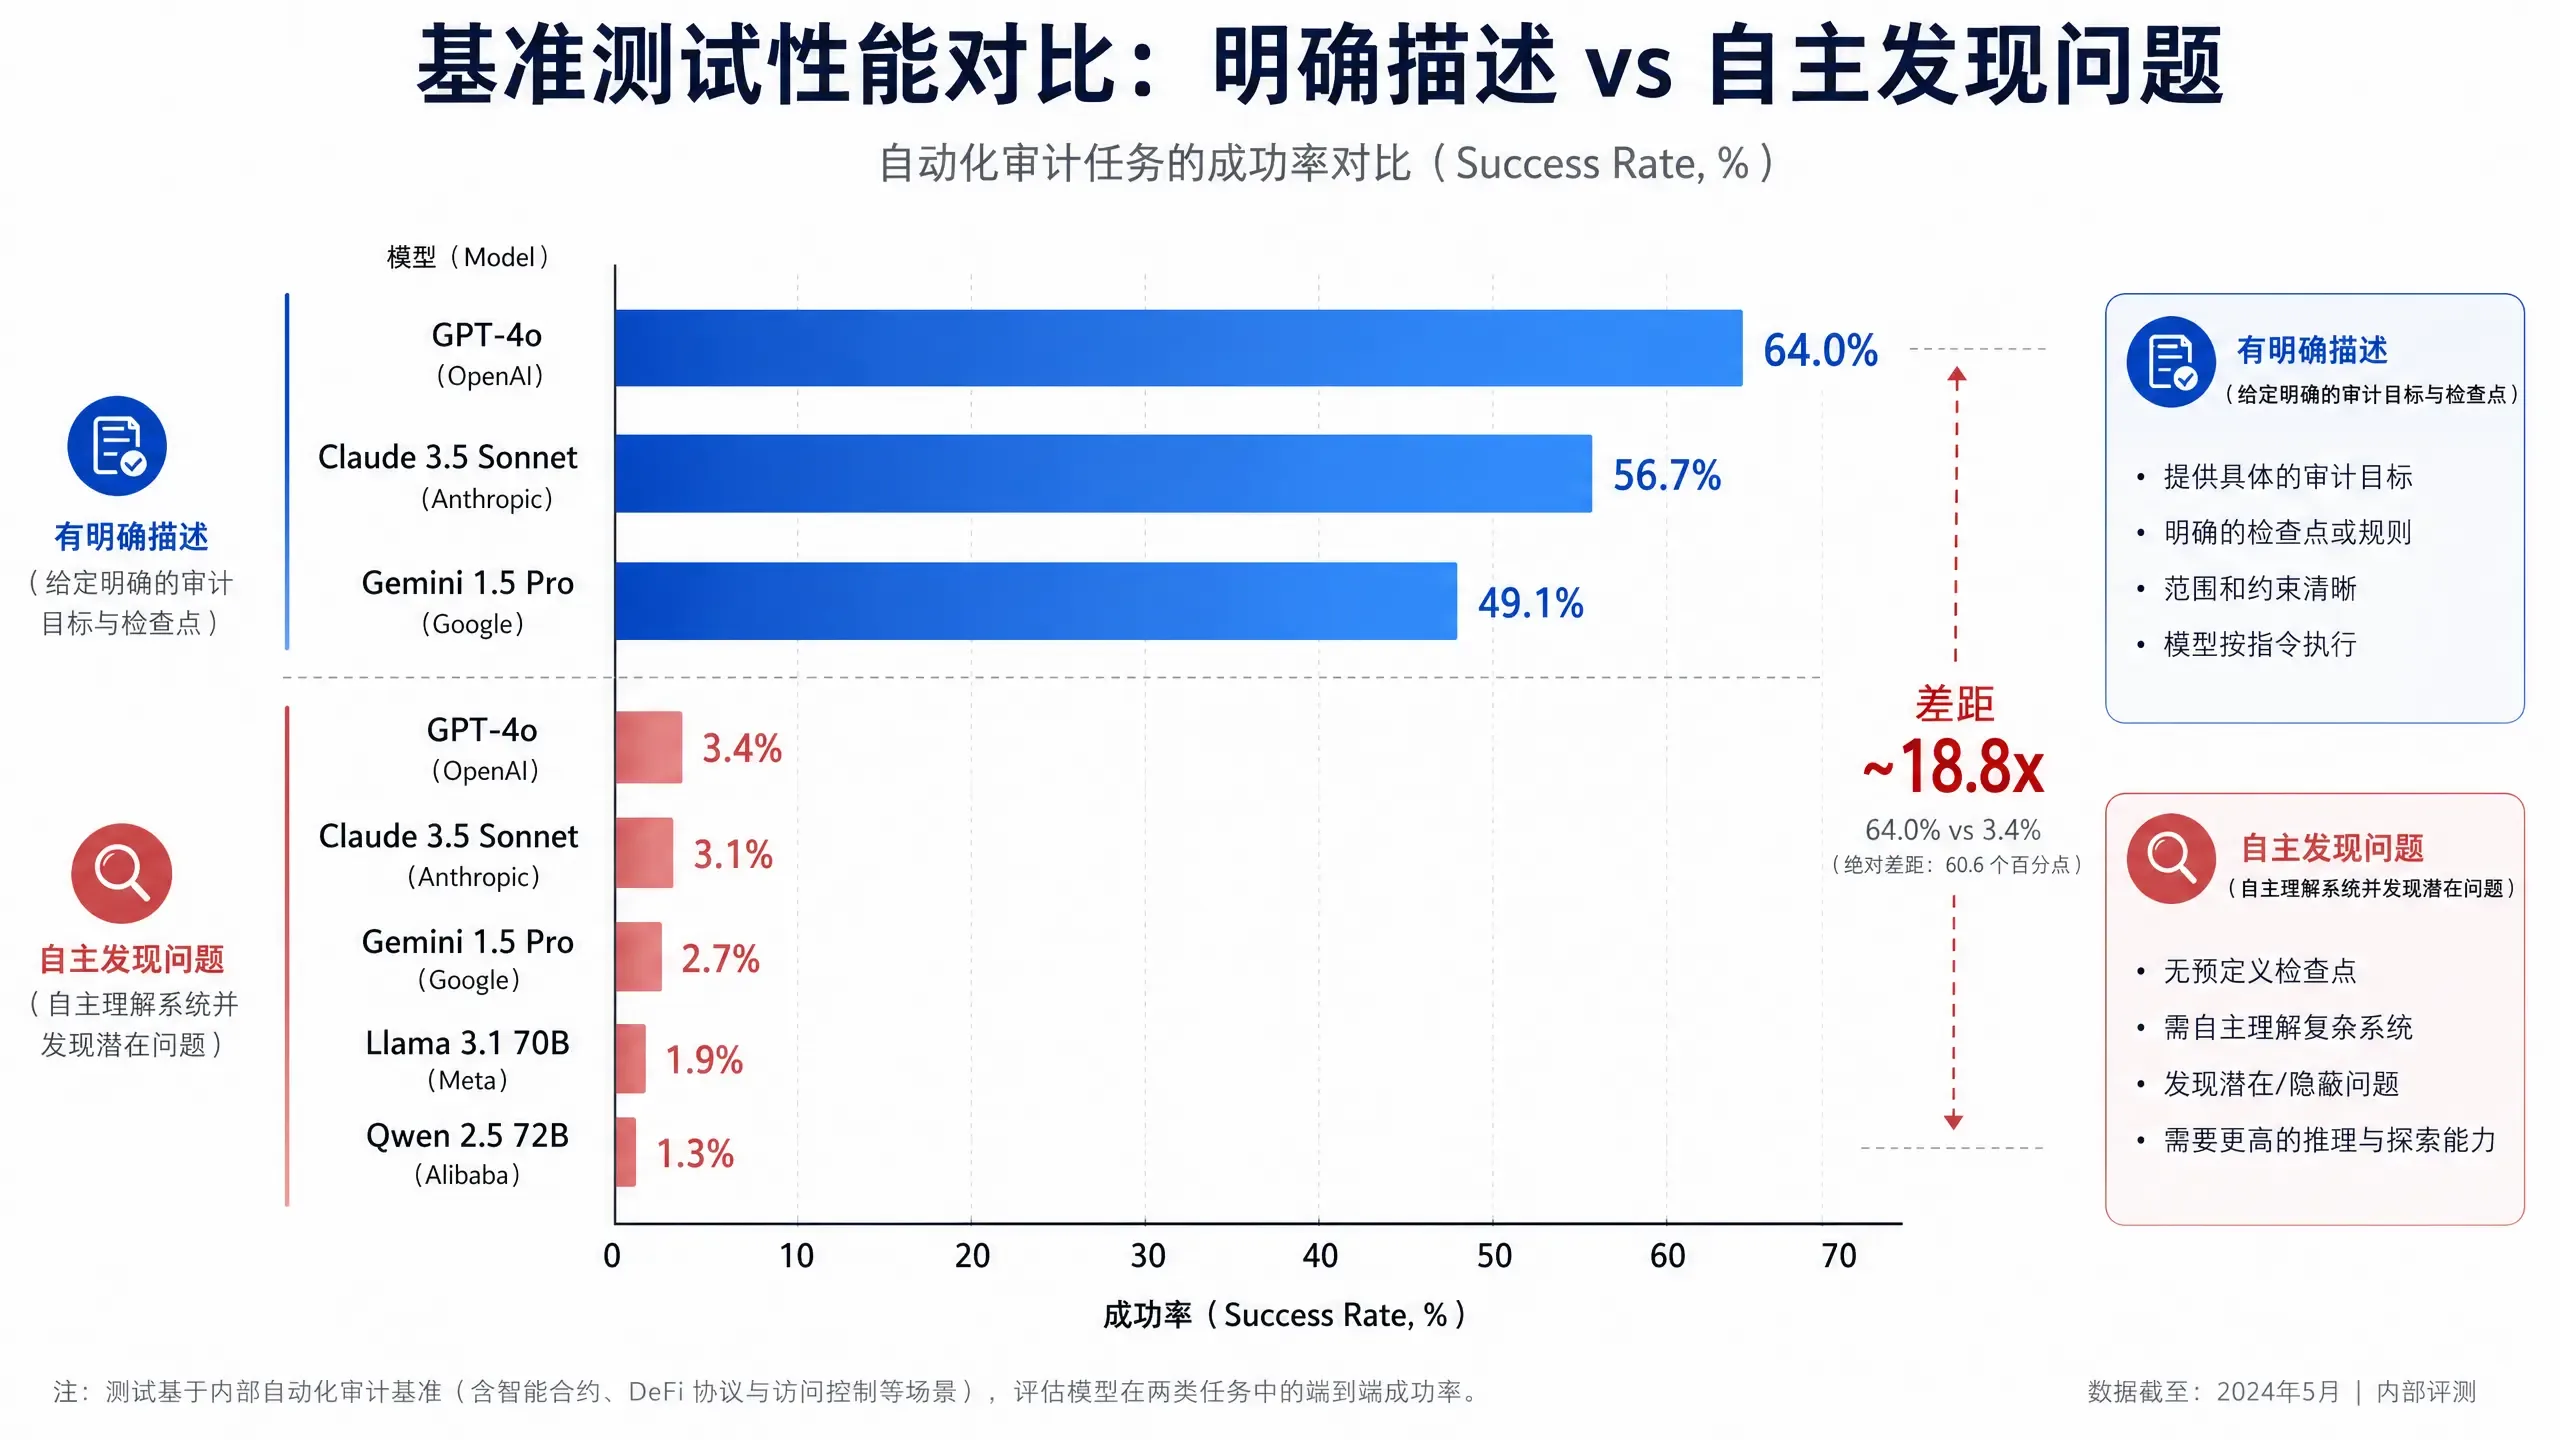
最好的模型/agent 也只解决了约 64% 的问题——而这些还只是“给你一个明确的 bug 描述让你去修”,比审计(要你自己发现问题)简单一个量级。如果在有明确目标的情况下成功率只有 64%,那么在需要自主发现问题的审计场景中,可靠性只会远低于此。
同一底座模型,不同 agent 架构差距只有约 6 个百分点。Auggie(51.8%) vs Claude Code(49.8%) vs SEAL 基线(45.9%),说明 agent 架构有帮助但不是决定性因素。瓶颈在 LLM 核心推理能力本身,而非工程实现。再精巧的 agent 架构也无法弥补模型在全局理解和多步推理上的根本性不足。
Verified → Pro 的成绩直接腰斩: Opus 4.5 在 Verified 上 80.9%,在 Pro 上仅 45.9%(标准化 scaffold)。这说明 Verified 的高分相当一部分来自数据污染和 benchmark 过拟合。当面对真正未见过的问题时,模型的表现大幅下降。这对我们理解 LLM 的真实能力至关重要:宣传材料中的高分往往不代表实战能力。
3.2 SWE-bench Verified:参考价值有限
为了完整性,我们仍然列出 Verified 的成绩,但需要明确其局限性:
| 排名 | 模型 | SWE-bench Verified 得分 | 说明 |
|---|---|---|---|
| 1 | Claude Mythos Preview | 93.9% | 限制访问,非公开模型 |
| 2 | Claude Opus 4.7 | 87.6% | 2026-04-16 发布 |
| 3 | GPT-5.3-Codex | 85.0% | |
| 4 | Claude Opus 4.5 | 80.9% | |
| 5 | Claude Opus 4.6 | 80.8% | |
| 6 | Gemini 3.1 Pro | 80.6% |
⚠️ 注意: Verified 已被确认存在数据污染问题。OpenAI 审计发现 59.4% 的最难未解问题存在测试用例缺陷。这些高分应仅作为方向性参考,不代表模型的真实工程能力。
3.3 Pro 得分对审计场景意味着什么?
SWE-bench Pro 是“给你明确的 bug 描述 → 让你去修”,这比审计简单得多。审计要求模型在没有明确 bug 描述的情况下自己发现问题,问题可能不在代码表面而是架构设计层面的缺陷,并且需要系统性覆盖以确保没有遗漏。
如果“有明确描述 + 修一个 bug”的成功率只有 45-64%,那“自己发现问题 + 全局系统性覆盖”的可靠性只会远低于此。这不是悲观,而是基于数据的现实评估。
四、主流工具真实能力概述(2026 年 4 月最新)
理解了理论瓶颈和基准数据后,我们来看看主流工具的实际定位和能力边界:
| 工具 | 真实定位 | 对大代码库的处理方式 | 适合做什么 | 不适合做什么 |
|---|---|---|---|---|
| Cursor | 日常开发 IDE | 全仓库语义索引 + Composer 多文件编辑 | 单模块开发、快速迭代、代码补全 | 全局架构审计、跨模块依赖分析 |
| Claude Code | 复杂推理 + Agentic 开发 | 运行时文件探索 + CLAUDE.md 项目记忆 + 1M 上下文 | 复杂重构、架构分析、新功能规划 | 无人监督的全局审计 |
| Augment Code | 企业级大仓库开发 | Context Engine(语义依赖图 + 实时索引 40 万+ 文件) | 大型遗留系统的辅助开发和代码审查 | 替代人类审计员做全局审计 |
| Sourcegraph Cody | 企业级代码搜索 + AI 辅助 | SCIP 代码图 + 嵌入 RAG + 符号依赖图 | 跨仓库检索、精确代码导航 | 自主发现设计缺陷 |
| Continue.dev | PR 级 AI 检查(已转型) | PR diff 级别的规则检查 | CI/CD 集成的自动化代码审查 | 项目级全局分析 |
补充说明:
Augment Context Engine 在检索层面确实最强。在 SWE-bench Pro 中,使用同一底座模型(Opus 4.5), Auggie(51.8%)比裸 SEAL scaffold(45.9%)高出约 6 个百分点,证明其语义依赖图在跨文件检索上有真实优势。但检索优势不等于全局审计能力——它能帮你更快找到相关代码,但不能替你判断代码的正确性。
Continue.dev 已转型。2026 年主要定位为 PR 级 AI check 工具(在每个 pull request 上跑 AI 检查作为 GitHub status check),不再以通用编码助手为主推功能。GitHub stars 约 32.8K。
这些工具都很有价值,但它们解决的是**“帮开发者更快找到相关代码并辅助修改”,不是“替代人类做全局审计”**。认清这个定位,才能合理使用这些工具,避免不切实际的期望。
五、游戏项目(Unity)的特殊困难
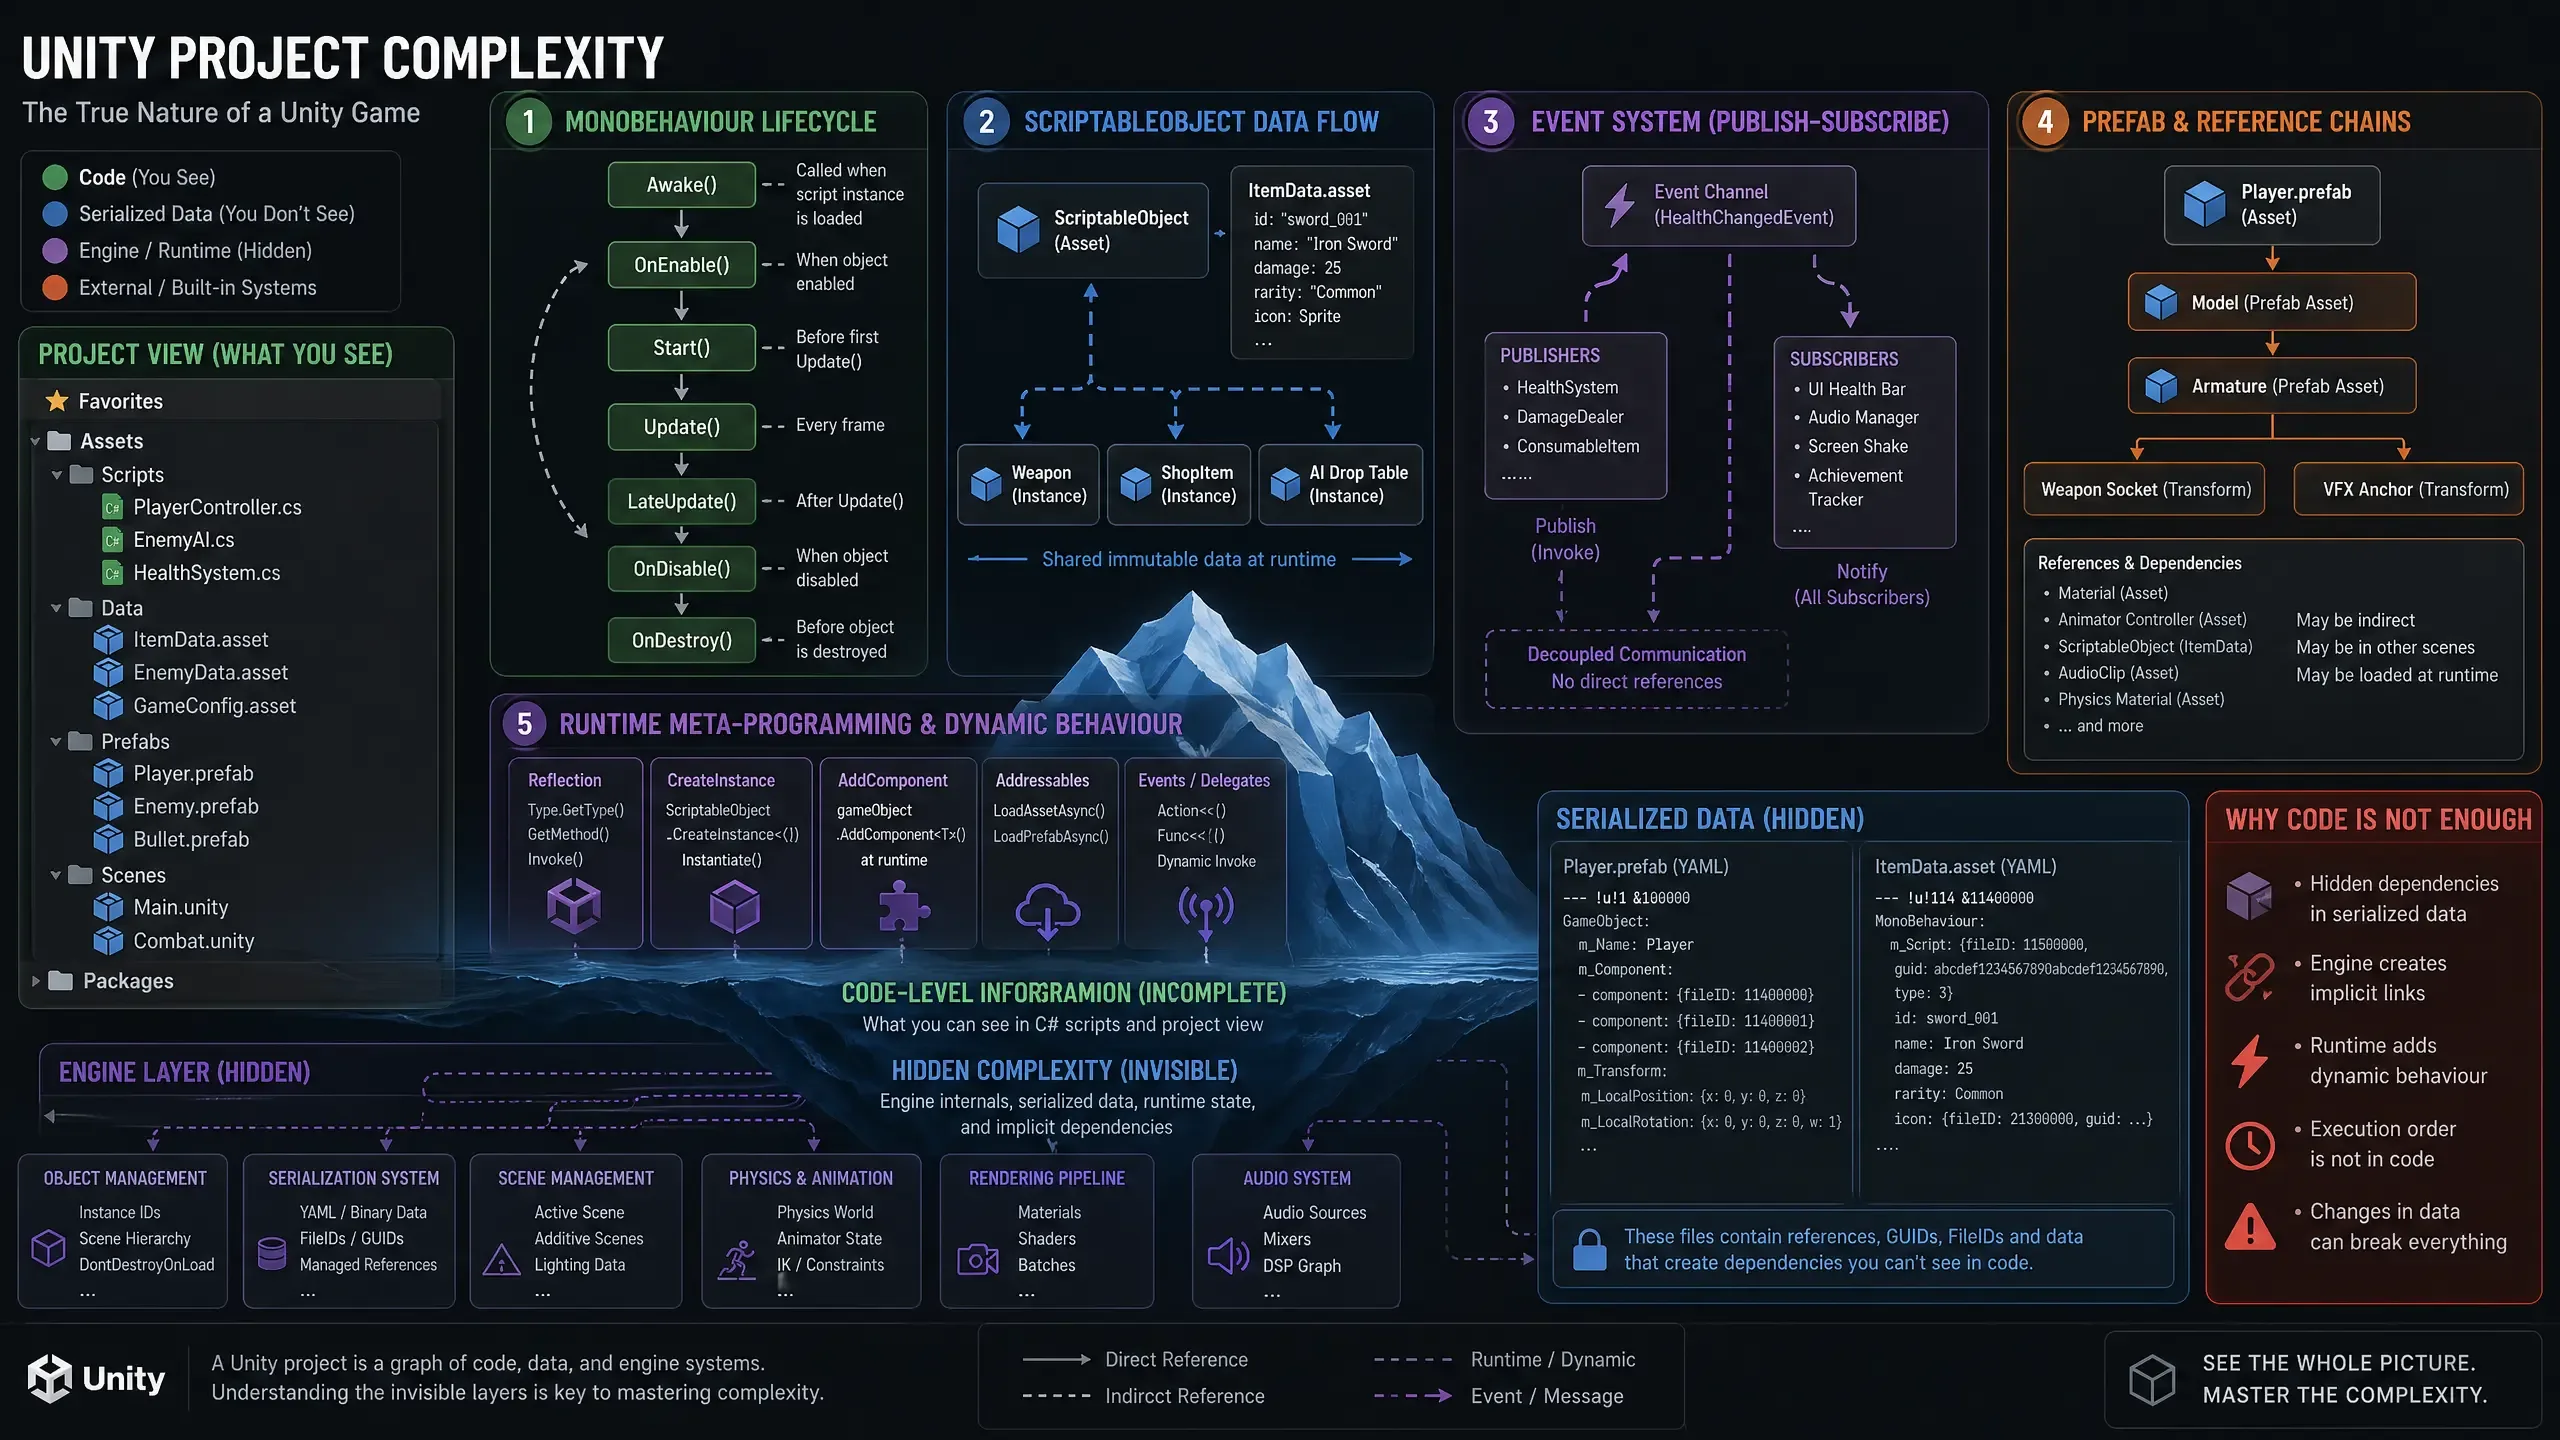
50 万行的中度游戏项目,对 LLM 审计来说有额外的噩梦级难点。这些困难源于游戏引擎的特殊架构,使得代码层面的信息严重不完整:
MonoBehaviour 生命周期耦合是第一个挑战。Awake、Start、Update、OnDestroy 的执行顺序依赖隐含在 Unity 引擎中,不在代码里。模型看到的只是一堆方法定义,无法理解它们的调用时序和相互依赖。
ScriptableObject 数据流构成了第二层复杂性。静态配置 → 运行时实例化 → 跨场景引用,数据流在代码层面看不完整。你需要同时理解代码逻辑和 Unity 编辑器中的配置数据,才能追踪一个数据对象的完整生命周期。
事件系统和消息总线带来了隐式依赖的噩梦。发布-订阅模式的依赖关系,grep 找不全,向量检索更找不全。两个模块之间可能没有任何显式的代码引用,但在运行时通过事件系统紧密耦合。
Prefab / Scene 引用链是最致命的。大量依赖关系存在于 Unity 编辑器的序列化数据(.prefab / .unity / .asset 文件)中,不在代码里。一个脚本可能被 50 个 prefab 引用,但在代码层面你完全看不到这些引用。
IL2CPP、反射和热更新机制对静态分析工具天然不友好。元编程逻辑意味着很多代码行为在运行时才确定,静态分析根本无法覆盖。
传统的 AST 分析对 Unity 项目的覆盖率远低于普通软件项目,因为太多逻辑存在于引擎层和序列化数据层。LLM 就更不用说了——它连完整的输入都拿不到,如何做全局审计?
六、正确的预期和实际可执行的方案
基于前面的分析,我们需要建立正确的预期,并制定实际可行的方案。
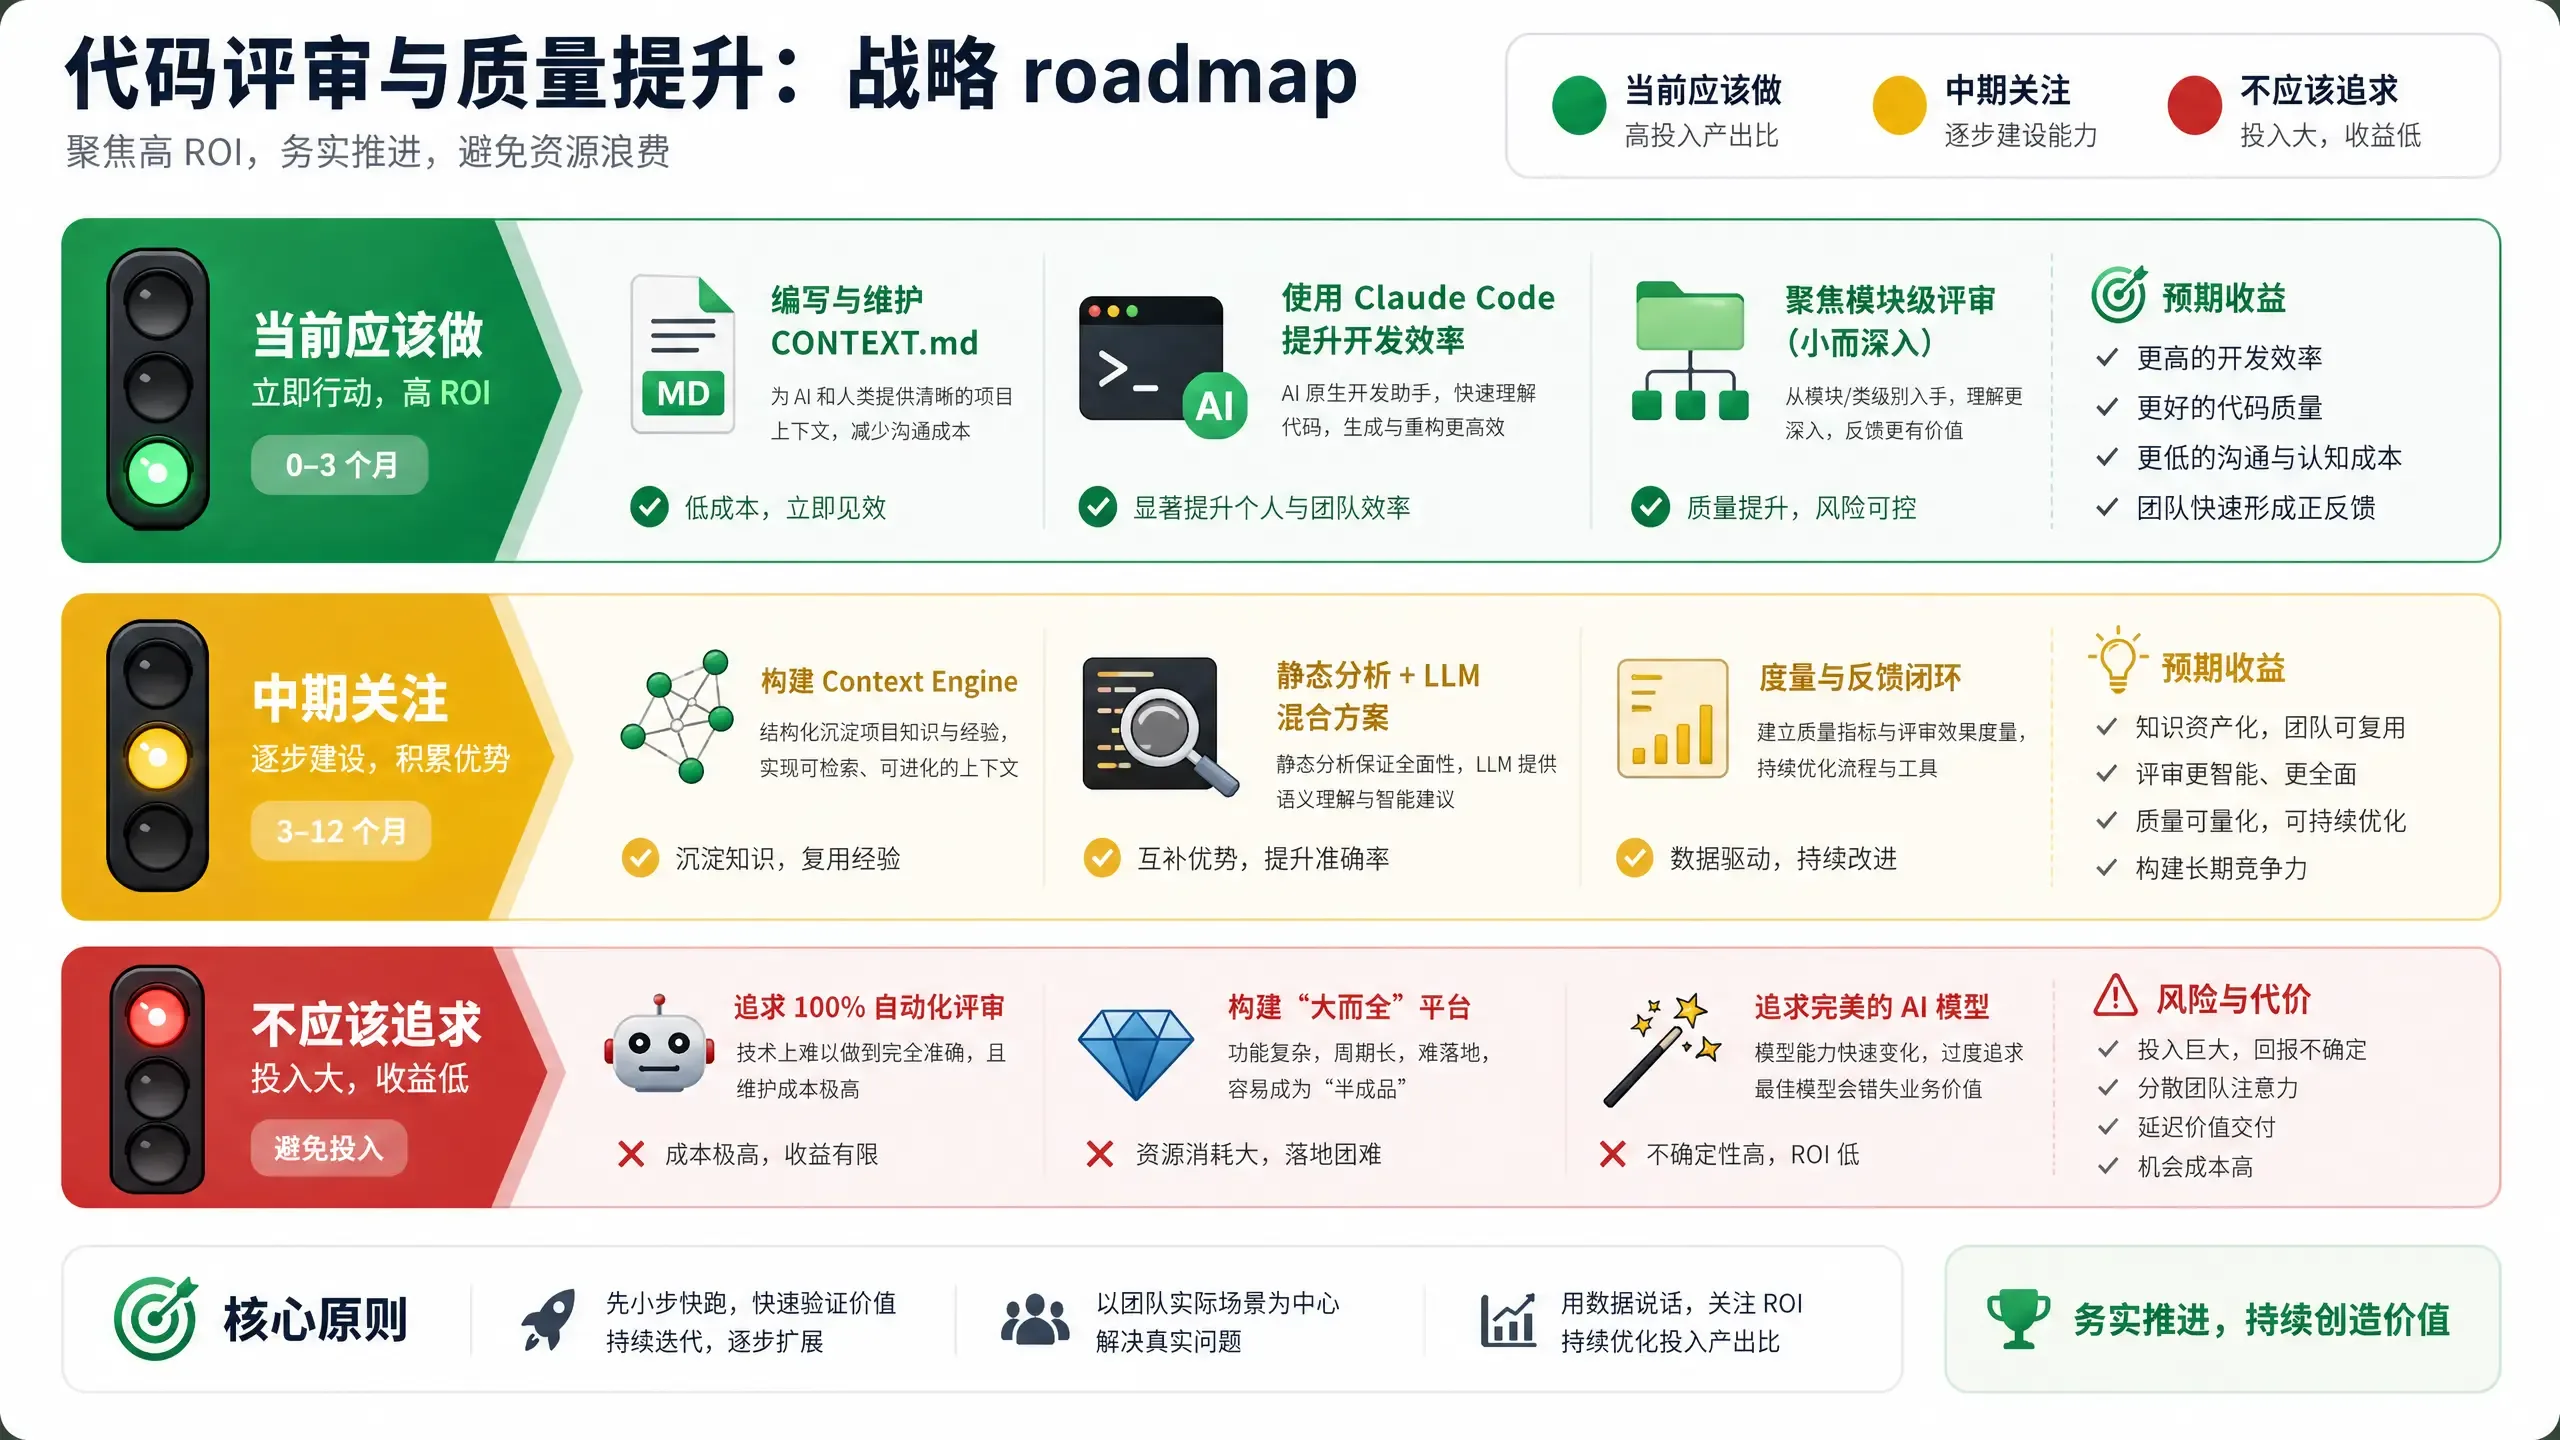
6.1 当前应该做的(投入产出比高)
**写好 CONTEXT.md / CLAUDE.md 是成本最低的第一步。把项目架构、模块职责、核心约定、anti-patterns 写清楚。这是当前降低幻觉最有效的手段。模型缺乏全局理解能力,但它能很好地遵循明确的指引。与其期待模型自己理解架构,不如直接告诉它。
用 Claude Code 做 Agentic 辅助开发。让模型在任务执行过程中主动检索和验证,而不是一次性理解整个项目。适合复杂重构、新功能开发、代码解释。利用 Opus 4.7 的 1M 上下文 + task budget 功能控制成本。这是当前 LLM 能力的甜区。
模块级 AI 代码审查在 PR / MR 级别使用 AI 辅助 review,范围限定在单次变更涉及的文件。这是当前 AI 代码审查的甜区——问题明确、范围可控、人在环路。Continue.dev 的 PR check 功能就是针对这个场景设计的。
建立模块级摘要索引。对项目中每个关键模块生成结构化摘要(职责、核心 API、依赖关系、数据流),供模型在需要时查阅。这相当于为模型构建了一个“项目地图”,弥补它缺乏全局心智模型的不足。
6.2 中期可以关注的方向
**Augment Code 的 Context Engine ** 在大仓库语义检索上目前最强,值得评估。SWE-bench Pro 验证有约 6 点优势,这在实际开发中能带来明显的效率提升。但要清楚它解决的是检索问题,不是审计问题。
传统静态分析 + LLM 结合 SonarQube 等工具的规则检查 + LLM 的语义补充,互补效果好。静态分析工具能系统性覆盖,LLM 能理解语义和上下文。两者结合能覆盖更广的问题类型。
AST + 符号级索引 比纯向量检索更靠谱,能追踪函数调用链和类型依赖。Sourcegraph 的 SCIP 代码图就是这个方向。对于需要精确追踪依赖关系的场景,这比语义检索更可靠。
6.3 不应该追求的
我们需要明确哪些方向在当前技术水平下是不现实的,避免浪费资源:
❌ 让模型“一次性吃下”整个项目并形成全局理解——上下文窗口的扩大并没有解决理解和推理的根本问题
❌ 期望 RAG 能替代人类做跨模块的逻辑审计——检索不等于理解,找到代码不等于判断正确性
❌ 依赖任何单一工具完成 50 万行级别的全局审计——这超出了当前所有工具的能力边界
❌ 因为工具宣称“支持百万行”就认为问题已解决——索引能力和审计能力是两回事
七、结论
AI 编码工具在 2026 年是优秀的“副驾驶”,但不是合格的“审计员”。
它能帮你更快地理解代码、更高效地开发和做局部审查,在这些场景中已经展现出巨大价值。Cursor 让日常开发效率提升数倍,Claude Code 能处理复杂的多文件重构,Augment 在大型遗留系统中的检索能力令人印象深刻。这些都是真实的、可量化的生产力提升。
但 50 万行级别的全局代码审计——发现架构缺陷、跨模块隐含依赖、遗漏的边界条件——仍然需要有经验的人类工程师来主导,AI 只能在其中提供辅助。基准测试数据清楚地表明,即使在有明确问题描述的情况下,最好的模型也只能解决约 64% 的问题。在需要自主发现问题的审计场景中,这个比例只会更低。
对模型保持合理预期,既不低估它在辅助开发上的价值,也不高估它在全局理解上的能力——这才是用好 AI 工具的前提。技术决策应该基于数据和现实能力边界,而非营销宣传和美好愿望。
数据来源
| # | 数据项 | 来源 | URL | 更新时间 |
|---|---|---|---|---|
| 1 | Claude Opus 4.7 发布信息、1M 上下文、$5/$25 定价、SWE-bench Verified 87.6%、Pro 64.3% | Anthropic 官方 / llm-stats.com | platform.claude.com/docs/en/about-claude/models/whats-new-claude-4-7 / llm-stats.com/blog/research/claude-opus-4-7-launch | 2026-04-16 |
| 2 | Claude Opus 4.6 MRCR v2 多针检索准确率 76%(vs Sonnet 4.5 的 18.5%) | Anthropic 官方 / InfoQ | infoq.com/news/2026/03/opus-4-6-context-compaction | 2026-03-12 |
| 3 | Claude Opus 4.6/Sonnet 4.6 1M 上下文标准定价 GA(取消长上下文溢价) | Anthropic 官方 | platform.claude.com/docs/en/about-claude/pricing | 2026-03-13 |
| 4 | Opus 4.7 新 tokenizer 同文本多 0-35% token | Anthropic What‘s New 文档 | platform.claude.com/docs/en/about-claude/models/whats-new-claude-4-7 | 2026-04-16 |
| 5 | SWE-bench Pro 基准说明(1,865 题、41 仓库、平均 4.1 文件/107 行) | Scale AI 官方 | labs.scale.com/leaderboard/swe_bench_pro_public | 持续更新 |
| 6 | SWE-bench Pro SEAL 排行榜(标准化 scaffold 得分) | marc0.dev 聚合排行 | marc0.dev/en/leaderboard | 2026-04-26 |
| 7 | SWE-bench Pro Agent 系统得分(Auggie 51.8%、Cursor 50.2%、Claude Code 49.8%) | Augment Code 官方 / ThePlanetTools | augmentcode.com/blog/auggie-tops-swe-bench-pro / theplanettools.ai/blog/augment-code-review-2026-swe-bench-pro | 2026-02 / 2026-04 |
| 8 | OpenAI 审计:SWE-bench Verified 数据污染 + 59.4% 测试用例缺陷 | CodeAnt AI / Morph 分析 | codeant.ai/blogs/swe-bench-scores / morphllm.com/swe-bench-pro | 2026-04 |
| 9 | SWE-bench Verified 排行(Mythos 93.9%、Opus 4.7 87.6% 等) | BenchLM / llm-stats | benchlm.ai/benchmarks/swePro / llm-stats.com/benchmarks/swe-bench-verified | 2026-04-25 |
| 10 | Gemini 2.5 Pro 1M 上下文、200K+ 2x 溢价 | Google 官方 / TokenMix | ai.google.dev/gemini-api/docs/long-context / tokenmix.ai/blog/gemini-2-5-pro-review | 2026-04 |
| 11 | GPT-5.4 1M 上下文、272K+ 2x 溢价 | Groundy 对比分析 | groundy.com/articles/gemini-2-0-pro-s-2-million-token-context-what-can-you | 2026-03 |
| 12 | 独立开发者 >700K token 性能下降反馈 | Signals (HN 聚合) / Substack | signals.aktagon.com / karozieminski.substack.com | 2026-03 |
| 13 | Cognition agent 60% 时间花在搜索上 | Morph AI 编码基准分析 | morphllm.com/ai-coding-benchmarks-2026 | 2026-03 |
| 14 | Continue.dev GitHub stars ~32.8K 及产品转型 | GitHub 官方仓库 | github.com/continuedev/continue | 2026-04 |
| 15 | Augment Code Context Engine 索引 40 万+ 文件 | Augment 官方 / VentureBeat | augmentcode.com/guides/claude-code-vs-augment-code / venturebeat.com | 2026-04 / 2025-12 |
文档整理日期:2026 年 4 月 26 日
文档作者:SagaSu