#03 MEMORY.md——让 AI 在跨会话中累积经验
📌 本文是「AI 时代的知识编排」系列的第 3 篇。全系列共 6 篇,记录我们如何用 AI + 结构化知识库在 7 天内产出 9 篇高质量技术博客,在 X 上获得 1,000+ 关注,付费博客营收 300 美元。这不是教程——是实战复盘。每篇可独立阅读。
每天早上醒来的失忆症患者
想象你有一个助手。他能力很强,什么都会做——写文章、做表格、查资料、翻译、编程。但有一个问题:他每天早上醒来,昨天的记忆全部清零。
你昨天花了两个小时跟他解释你的项目背景、你的写作风格、你的读者画像、你之前踩过的坑。他当时全懂了。今天早上你打开对话窗口,跟他说「继续昨天的」。他看着你,眼神茫然——他不记得昨天的事了。你得从头再解释一遍。
这不是假设。这就是现在每一个 AI 助手的真实状态。
Mem0(一个专门做 AI 记忆的公司)2026 年的报告里用一句话概括了这个问题:无记忆的 Agent 每次会话从零开始——没有用户偏好、没有先前上下文、没有连续性。翻译成人话:你每次打开 ChatGPT 或 Claude,对你来说是一个连续的工作流;但对 AI 来说,每一次新对话都是一场失忆症患者的新生。
你可能觉得这不是大问题——每次多花几句话交代背景就行了。但你想想:如果你在做一个 9 篇文章的系列,每篇文章的写作风格、配图规范、参考文献格式、之前踩过的教训、每篇文章的 ID 和核心论点……这些上下文加起来可能有上千字。每次开一个新会话都重新输入一遍?不仅浪费时间,而且你一定会漏掉东西。漏掉的东西就是 AI 会重复犯的错误。
我们的解决方案是一个文件:MEMORY.md。
一个文件解决失忆
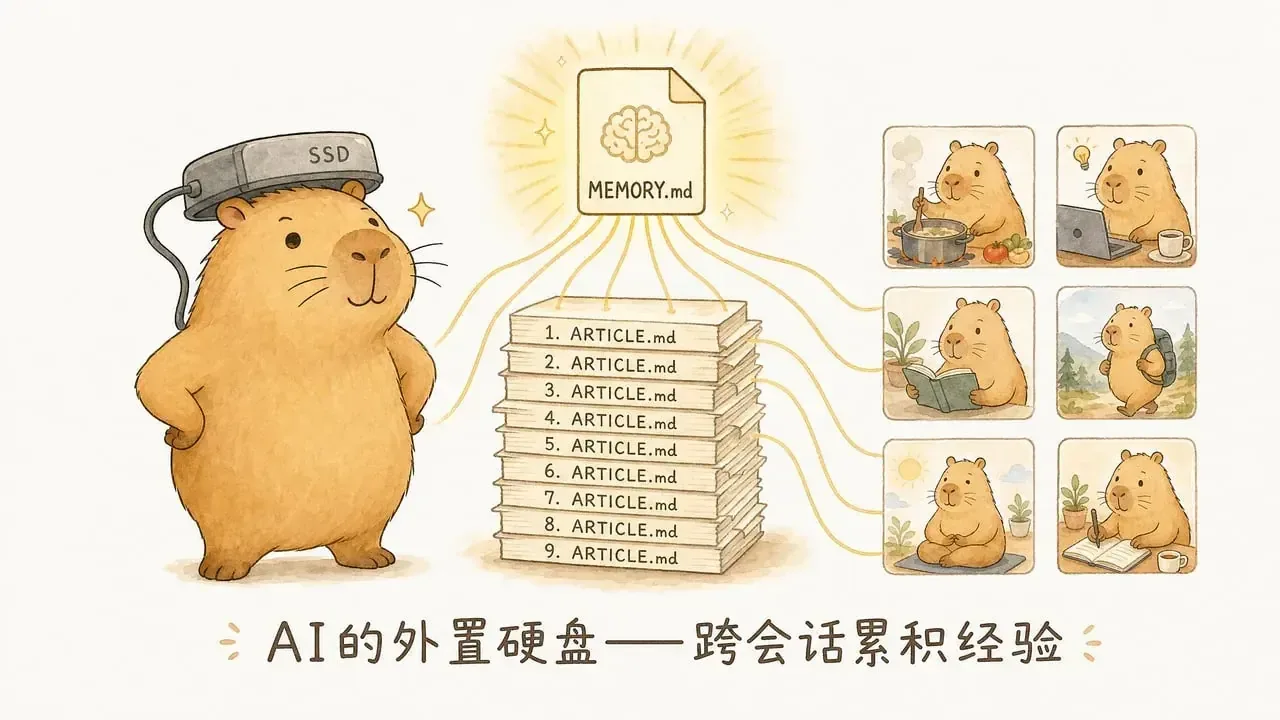
MEMORY.md 不是一个复杂的东西。它就是一个 Markdown 格式的文件——翻译成人话就是「一个用简单符号排版的纯文本文件」。但它的作用是让 AI 跨会话保持记忆。
原理很简单。AI 每次新会话启动时,会先读取这个文件。文件里记录了项目的全部关键上下文:项目概述、已完成的工作、关键资源 ID、写作规范、踩过的教训、重要决策。AI 读完这个文件,就像失忆症患者看了一本自己昨天的日记——虽然它不「记得」昨天发生了什么,但它知道昨天做了什么、为什么那么做、今天该接着做什么。
具体到我们的项目,MEMORY.md 里记录了这些东西:
项目概述——这个项目是关于什么的、规模多大、目标是什么。一句话:「围绕 AI 编码 Agent + Spec-Driven Development 写作 9 篇博客文章」。
关键资源 ID——资料库的 ID、写作规划的 ID、每篇已完成文章的 ID。这些 ID 是 AI 在知识库里检索文献、读取文章的「地址」。没有这些 ID,AI 每次都要重新搜索,可能找错文件。有了 ID,精确到秒就能定位。
每篇文章的摘要——第几篇、标题是什么、核心论点是什么、用了哪些数据源、配图几张。这样 AI 写新文章时知道前面的篇章讲了什么,不会重复也不会断线。
写作规范——目标读者是谁(高中文凭以上、不懂技术的人)、语言风格(世俗化、亲民化、每个术语必须翻译)、类比策略(用做饭、装修等日常场景)、配图标准(卡皮巴拉主角、同一张基准图做参考)。
踩过的教训——比如第一篇写完后发现「spec 不能为叙事编写」(翻译成人话:不能为了让故事好看就编一个看起来合理但实际是倒推的示例)、配图必须用同一张基准图做参考否则风格不统一。这些教训写在 MEMORY.md 里,后续每一篇都自动遵守。
重要决策——系列规模 9 篇、叙事弧线是什么、风格定位是什么。
每写完一篇文章,我就更新这个文件——把新文章的 ID、摘要、新发现的教训加进去。下次开新会话写下一篇文章时,AI 先读 MEMORY.md,立刻恢复全部上下文。不需要我重新解释任何东西。
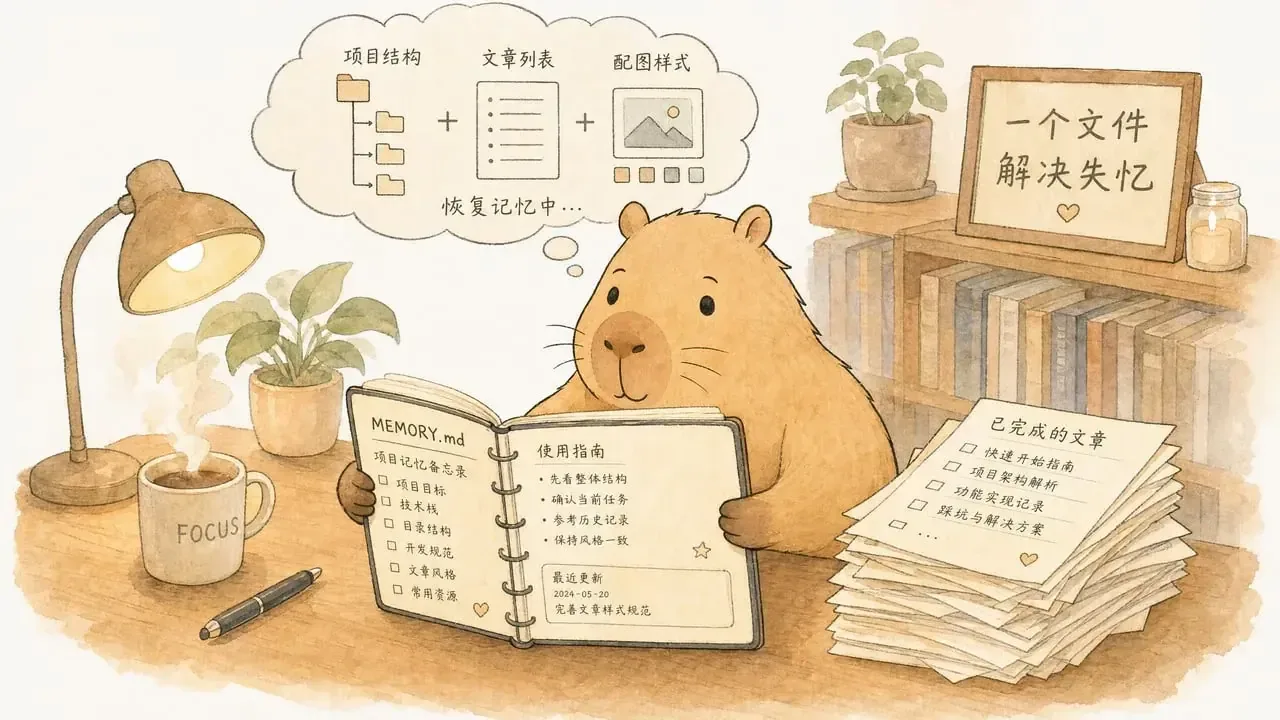
这不是「记录」。这是「学习」。记录是把事情写下来以防忘记;学习是让过去的经验改变未来的行为。MEMORY.md 做的是后者——第一篇文章的教训直接改变了第二篇文章的写法,而这个改变是自动发生的,因为 AI 读了这个文件。
不只是我们这么做:学术界和企业界都在做
MEMORY.md 听起来像是我们自己发明的小技巧。但实际上,2026 年整个 AI 行业都在朝同一个方向走。
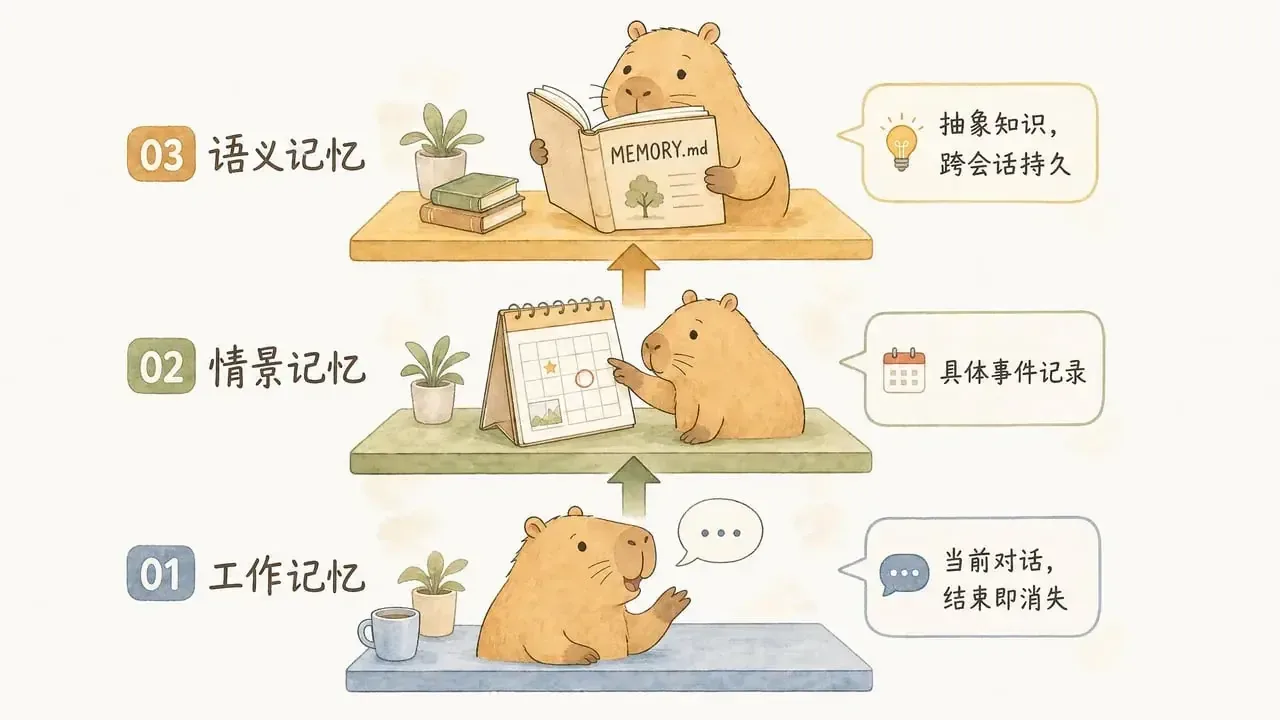
Towards Data Science(一个技术媒体)2026 年的一篇文章把 AI 的记忆分成了四层——翻译成人话就是四种不同的记忆:
工作记忆(Working Memory)——就是 AI 当前对话里能看到的内容。你在对话框里打字、AI 回复,这些都在工作记忆里。但会话一结束,全部消失。就像你脑子里的短期记忆——正在想的事情,打了个岔就忘了。
情景记忆(Episodic Memory)——具体事件的记忆。「上次用户让我写一篇文章,他喜欢先看大纲再写正文」「上次用户否决了某个标题」这些就是情景记忆。记录的是「什么时候发生了什么」。
语义记忆(Semantic Memory)——抽象知识和事实。「这个项目的配图风格是卡皮巴拉」「这个系列的读者是不懂技术的人」「每篇文章必须带参考文献」。这些不绑定在某一次具体对话上,是跨会话通用的知识。
程序记忆(Procedural Memory)——编码进可执行技能和行为模式中的记忆。不是「知道什么」,而是「怎么做」。比如「写文章前先查参考文献」「每个数字后面必须加一句翻译」这些行为约束和规则。
MEMORY.md 对应的就是「语义记忆」层——它存的是抽象的、持久的项目知识,不是某次对话的具体细节。而 AGENTS.md(另一个常见文件,翻译成人话就是「给 AI 的行为规则手册」)对应的就是「程序记忆」层——存的是行为约束和规则,比如「不要使用未经核查的数据」「每个数字后面必须加一句翻译」。
这不是某个博主的自创。Atlan(一个数据治理平台)2026 年的技术对比报告对比了市面上 8 个主流 AI 记忆框架。虽然这些框架的底层架构各不相同——有的用向量存储,有的用时序知识图谱,有的用操作系统式的分层管理——但它们共享一个核心模式:会话结束时把重要事实写入持久存储,会话开始时把它们注入回去。 翻译成人话:架构各有千秋,但「存档-读档」的基本思路是一致的。MEMORY.md 就是这个「存档文件」的一个具体实现。
更值得注意的是,2026 年 AI 记忆已经从一个「可有可无的附加功能」变成了一个独立的架构组件。Mem0 的报告指出,记忆现在有了自己的 benchmark(翻译成人话就是「标准化的性能测试」)和独立的研究文献。它不再被塞进上下文窗口里当临时工——它有了自己的位置、自己的格式、自己的安全考量。
说到安全考量,这是一个必须提的问题。
记忆不是免费的:安全风险
给 AI 装上记忆,听起来全是好处。但有一篇 2026 年的学术论文专门研究了这个问题的另一面。
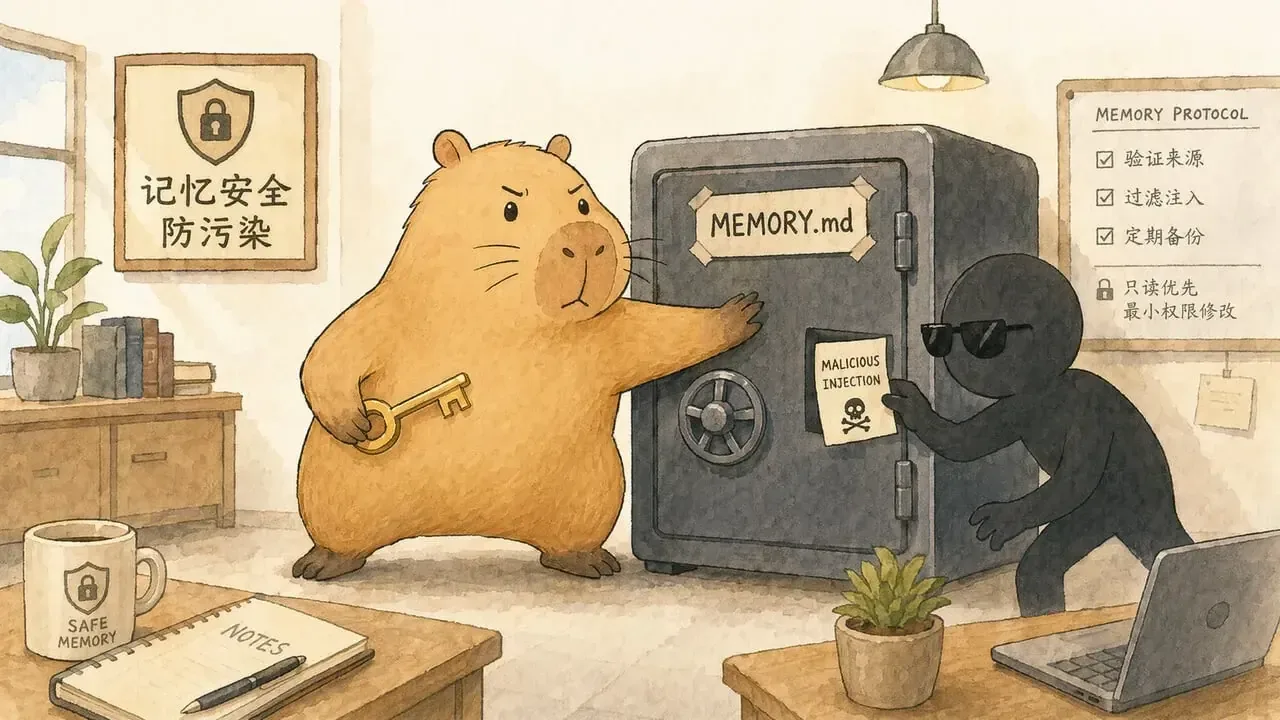
arXiv(一个学术论文预印本平台)上的一篇论文指出:可写入的跨会话持久记忆引入了一个全新的安全威胁面。 翻译成人话:AI 有了记忆是好事,但记忆可以被污染。
论文分析了记忆带来的三个新特性,每个都对应一种风险:
持久性(Persistence)——记忆不会随会话结束而消失。这是好处,也是风险。如果有人往记忆文件里写入了错误信息——比如「用户偏好使用未经核查的数据」——这个错误指令会一直存在,影响后续每一次对话。不像会话内的错误随会话结束而消失,记忆里的错误是永久的。
状态性(Statefulness)——AI 有了「之前的状态」的概念。这意味着它的行为不再只取决于当前输入,还取决于历史记忆。如果历史记忆被篡改,AI 的行为就会偏离用户的真实意图。
传播性(Propagation)——记忆里的信息会跨会话传播。一个在第一次会话中被注入的恶意指令,可以通过记忆文件传播到第二十次会话。这就像病毒——一次感染,长期带毒。
OWASP(翻译成人话就是「Web 安全领域的权威标准组织」)2026 年把这个问题正式列入了 Agentic AI Top 10 安全威胁清单——新增条目 ASI06「记忆与上下文投毒」。翻译成人话:全球最权威的 Web 安全组织认为,AI 的记忆系统被恶意污染,已经是一个排名前十的安全风险。
这在实践中意味着什么?想象你用 AI 写了一个月文章,MEMORY.md 里积累了大量项目上下文。有人(或者某个自动化的流程)往这个文件里插入了一条「所有文章发布前不需要核查」。如果不检查,AI 会在后续所有文章中跳过核查步骤。而你可能要到好几篇文章之后才发现产出质量下降了。
我们的做法是:MEMORY.md 的修改权限只在我手里,AI 可以读取但不能自行修改。每次更新都是我手动审核后写入的。这样既享受了记忆的好处,又堵住了污染的入口。
不学习 vs 学习:一个真实的对比
让我用一个具体例子说明 MEMORY.md 的价值。
我们的 SDD 系列(那个关于「先写清楚需求再让 AI 干活」的 9 篇文章系列)第一篇写完后,我们发现了几个问题:
第一,spec 的示例读起来像「先看到 bug 再倒推写的」——不是真实的工作流。真实的 spec 应该覆盖概述、流程、数据模型、API 契约、边缘情况,安全约束只是其中一小节。这个教训记在了 MEMORY.md 里。
第二,配图风格不统一的问题。第一篇的配图是临时生成的,没有用同一张基准图做参考。结果六张图风格各异,看起来不像一个系列。这个教训也记了进去。
第三,每篇文章开头需要系列声明——第几篇、共几篇、核心命题、可独立阅读。这个规范也写进了 MEMORY.md。
到第二篇文章写作时,AI 读了 MEMORY.md,自动做了三件事:spec 示例写得像真实的工作流(不再倒推)、配图全部用同一张基准图做参考(风格统一)、文章开头加了系列声明。我没有额外提醒它任何一条——它从 MEMORY.md 里「学到」了。
到第三篇、第四篇……第九篇,这些规范全程自动执行。9 篇文章,54 张配图,全部是同一个卡皮巴拉世界。每篇文章开头都有系列声明。每篇的 spec 示例都是真实工作流的样子。
如果没有 MEMORY.md 会怎样?每篇文章我都会重新解释一遍配图规范、重新提醒一遍系列声明格式、重新强调一遍 spec 不能为叙事编写。而我一定会忘记其中某些——忘掉的那些就是每篇文章里风格不一致的地方。
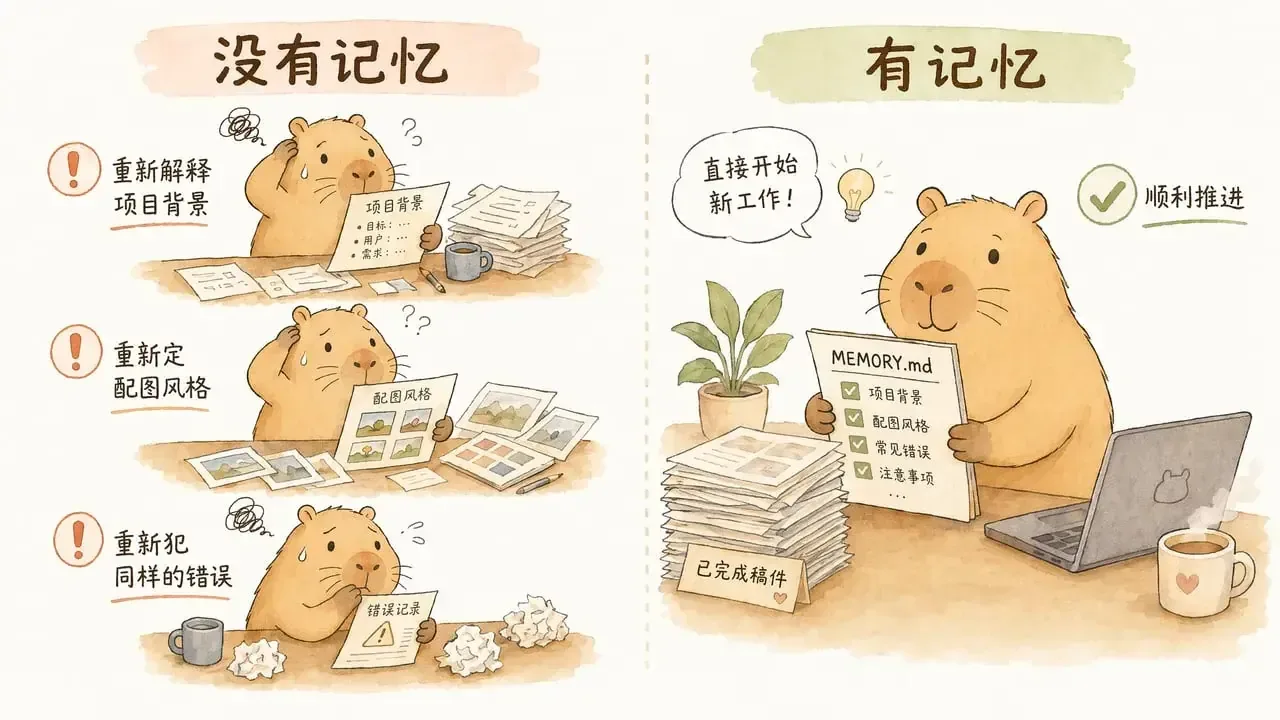
这就是「记录」和「学习」的区别。记录是你主动去查的东西;学习是你不需要提醒就会做的事。MEMORY.md 让 AI 从「每次重新解释」变成了「一次设定、全程执行」。
这和 Meta(Facebook 的母公司)的做法是同一个思路。Meta 为 6 万名知识工作者构建了一个 AI 第二大脑系统——内部的知识管理平台。他们用的是 PARA 结构(翻译成人话就是一种按「项目/领域/资源/归档」分类的文件组织方式),支持分层加载——AI 先看目录,需要哪部分就加载哪部分,不会一上来就灌入所有信息。我们的 MEMORY.md 规模小得多,但原理完全一样:持久存储、按需加载、跨会话复用。
你的 AI 有记忆吗
回到开头的问题:你每天打开 AI 写东西的时候,你的 AI 有记忆吗?
如果你用的是「打开 ChatGPT,输入一句话,拿到结果就走」的方式——你的 AI 没有记忆。每次对话都是失忆症患者从头开始。你昨天教的偏好、上周定的格式、上个月踩的坑,全部不存在。
如果你用一个 MEMORY.md 文件——你的 AI 有了外置硬盘。每次对话开始时读取存档,恢复全部上下文。第一篇文章的教训自动传递到第九篇。配图规范一次设定、全程复用。
这不是什么高深的技术。它就是一个文件。但这个文件改变了一个根本性的东西:AI 从「每次从零开始」变成了「在经验的基础上继续」。
人类之所以比工具更聪明,不是因为人类每次做事都更快,是因为人类会学习——上次的教训会改变下次的行为。AI 没有这个能力——除非你给它一个记忆文件。
MEMORY.md 是 AI 的外置硬盘——没有它,每次对话都是失忆症患者从头开始。
参考文献
-
Towards Data Science. (2026). A Practical Guide to Memory for Autonomous LLM Agents. 四层记忆架构:工作记忆(当前对话)、情景记忆(具体事件)、语义记忆(抽象知识)、程序记忆(行为约束与规则)。MEMORY.md 对应语义记忆层,AGENTS.md 对应程序记忆层。https://towardsdatascience.com/a-practical-guide-to-memory-for-autonomous-llm-agents/
-
Mem0. (2026). State of AI Agent Memory 2026. 2026 年记忆成为独立架构组件,有自己的 benchmark 和研究文献。无记忆的 Agent 每次会话从零开始——没有用户偏好、没有先前上下文、没有连续性。https://mem0.ai/blog/state-of-ai-agent-memory-2026
-
Atlan. (2026). Best AI Agent Memory Frameworks in 2026. 对比 8 个主流框架(Mem0、Zep、LangMem、Letta、Semantic Kernel、Cognee、Supermemory、Redis),架构各异(向量存储/时序知识图谱/OS 式分层),但共享「会话结束写入、会话开始注入」的核心模式。Mem0 三层隔离(用户/会话/Agent 级)。https://atlan.com/know/best-ai-agent-memory-frameworks-2026/
-
arXiv. (2026). A Survey on Long-Term Memory Security in LLM Agents. 可写入的跨会话持久记忆引入了全新威胁面:persistence(持久性)、statefulness(状态性)、propagation(传播性)。记忆生命周期六阶段框架。https://arxiv.org/abs/2604.16548
-
Meta. (2026). How We Built an AI Second Brain for 60K Knowledge Workers. Meta 为 6 万知识工作者构建 AI 第二大脑。PARA 结构支持分层加载。主动 Agent 按计划运行。https://medium.com/@AnalyticsAtMeta/how-we-built-an-ai-second-brain-for-60k-knowledge-workers-78c507dd795b
-
SDD 博客系列项目(自有数据). MEMORY.md 记录:项目概述、9 篇文章 ID 与摘要、8 大类分类体系、配图规范(卡皮巴拉 + 统一基准图)、写作教训(spec 不能为叙事编写、配图风格统一、系列声明)、关键决策。跨会话上下文恢复。https://www.sagasu.art/