OpenClaw实战教程系列第05篇 - 记忆系统:让 AI 记住你
AI 每次醒来都是一张白纸。记忆文件,就是它的前世记忆。
为什么需要记忆?
想象这样一个场景:
周一,你和 AI 讨论了一个登录功能的架构方案,AI 给出了详细建议,你们还一起优化了代码结构。
周三,你问 AI:“我们上次讨论的登录方案,数据库表结构怎么设计来着?”
没有记忆的 AI:“不好意思,我不记得我们之前讨论过什么。能重新描述一下你的需求吗?”
有记忆的 AI:“上次我们讨论的是基于 JWT 的无状态登录方案。数据库表结构我当时的建议是:
-
users 表:id, username, password_hash, created_at
-
refresh_tokens 表:id, user_id, token, expires_at
需要我重新展开详细设计吗?“
这就是记忆的价值。
OpenClaw 的记忆体系
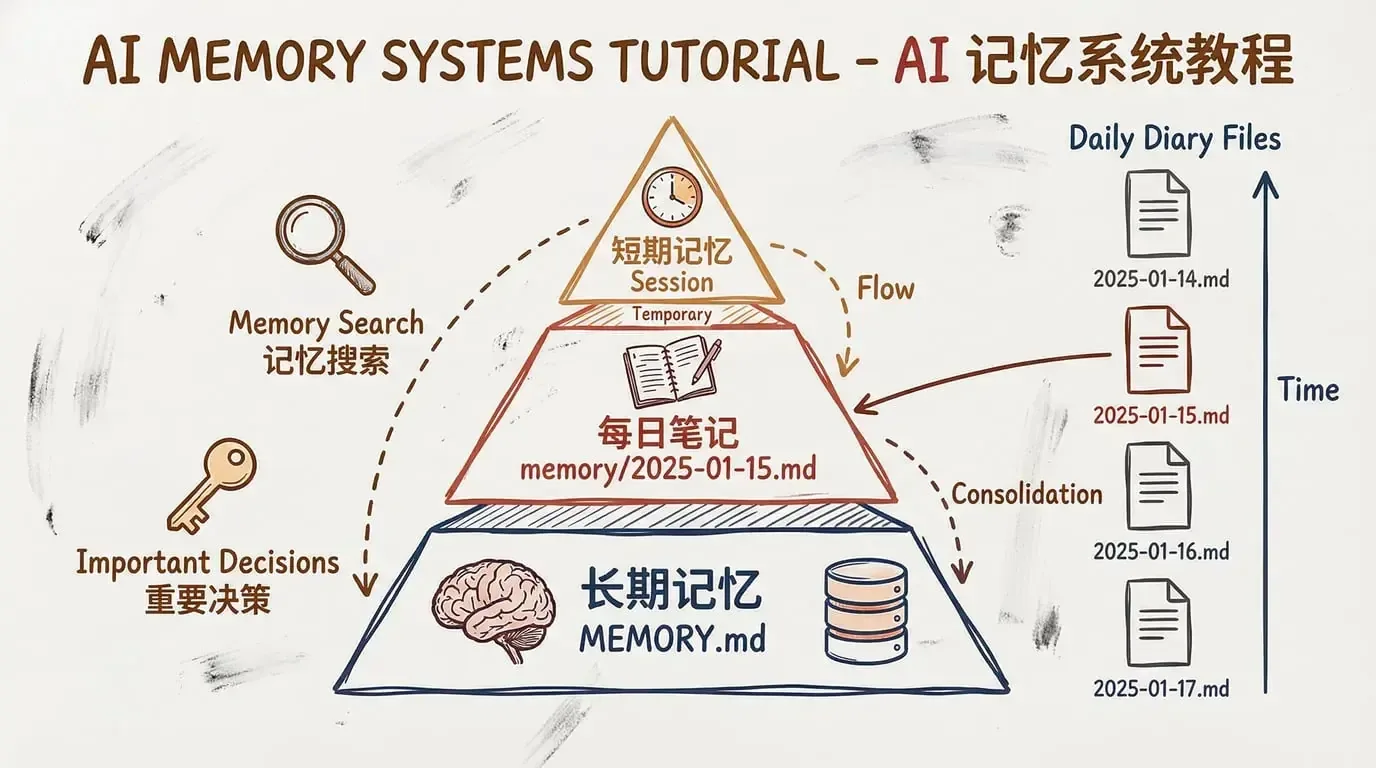
OpenClaw 采用三层记忆结构:
记忆金字塔

       ┌─────────────┐
       │  短期记忆    │  ← 当前会话上下文(200k token)
       │  Session    │     会随着对话变长而被"挤出"
       └──────┬──────┘
              │
       ┌──────┴──────┐
       │  每日笔记    │  ← memory/2025-01-15.md
       │  Daily Log  │     自动记录每天发生什么
       └──────┬──────┘
              │
       ┌──────┴──────┐
       │  长期记忆    │  ← MEMORY.md
       │  Long-term  │     提炼精华、持久保存
       └─────────────┘
| 层级 | 文件/位置 | 作用 | 谁维护 | 保存多久 |
|---|---|---|---|---|
| 短期记忆 | 当前会话上下文 | 记住本轮对话 | AI 自动 | 会话结束即消失 |
| 每日笔记 | memory/YYYY-MM-DD.md | 记录每天发生的事 | AI 自动 | 永久(可归档) |
| 长期记忆 | MEMORY.md | 提炼精华、重要信息 | AI/用户 | 永久(需维护) |
MEMORY.md:长期记忆的核心
存什么?不存什么?
✅ 应该存:
-
重要决策和方案(“我们决定用 PostgreSQL 而不是 MySQL”)
-
项目状态和进度(“博客重构完成 60%,卡在评论系统”)
-
经验教训(“上次用 Opus 跑 Cron 烧了 $50,记得用 Sonnet”)
-
个人偏好(“我喜欢先给结论的回复风格”)
-
关键链接和资源(“设计稿在 Figma:xxx”)
❌ 不应该存:
-
临时信息(“明天下午 3 点开”——放日历)
-
敏感密码(“服务器密码是 xxx”——用密码管理器)
-
大段原始内容(“这是整篇文章……”——存链接或摘要)
-
过期信息(已完成项目的详细过程)
结构示例
# MEMORY.md - 长期记忆

## 活跃项目(当前在做)

### OpenClaw 教程系列
- 状态:进行中,已完成 8/14 篇
- 关键决策:
  - 定价:基础版 ¥99,完整版 ¥199
  - 配图风格:手绘白板风(Nano Banana Pro)
  - 发布时间:2025-02-01
- 待办:
  - [ ] 完成剩余 6 篇
  - [ ] 生成所有配图
  - [ ] 制作宣传视频
- 相关文件:
  - 草稿目录:~/Documents/openclaw-tutorial/
  - 配图素材:~/Design/openclaw-images/

### 个人博客重构
- 状态:后端 API 完成,前端进行中
- 技术栈:Next.js + Tailwind + Prisma
- 卡点:评论系统还没定方案(考虑 Giscus vs Cusdis)
- 上次讨论:决定用 Giscus,因为免费 + 基于 GitHub Issues

## 重要决策记录

### 2025-01-20:OpenClaw 模型选型策略
背景:Cron 任务烧钱问题
决策:
- 自动化任务(Cron/Heartbeat)→ Gemini Flash(最便宜)
- 日常对话 → Claude 3.5 Sonnet(性价比)
- 复杂架构设计 → Claude 3 Opus(最强但贵)
结果:月成本从 $45 降到 $12

## 个人偏好(已验证)
- 沟通风格:先给结论,再展开
- 代码审查:必须给修改建议,不只是指出问题
- 技术偏好:Node.js > Python,PostgreSQL > MySQL

## 经验教训
- ❌ 不要在 Cron 里用 Opus(烧钱)
- ✅ Heartbeat 频率不要低于 30 分钟(省 Token)
- ✅ Gemini Flash 便宜到可以忽略,适合自动化
维护策略
AI 自动维护:
-
在 Heartbeat 中定期复盘每日笔记
-
自动将重要信息提炼到
MEMORY.md -
自动标记已完成项目为归档
用户手动维护:
-
每周花 5 分钟 review
MEMORY.md -
删除过时的项目信息
-
补充新的重要决策
每日笔记:memory/.md
自动创建机制
每天,AI 会自动创建一个日记文件:
~/.openclaw/workspace/memory/
├── 2025-01-15.md
├── 2025-01-16.md
├── 2025-01-17.md
└── ...
内容示例
# 2025-01-15 日记

## 今天做了什么
- 完成了 OpenClaw 教程第 4 篇(个性化)
- 配置了 Telegram Bot,测试通过
- 优化了 SOUL.md,AI 回复风格明显改善

## 遇到的问题
- Discord Bot 收不到消息 → 发现是 Message Content Intent 没开
- 解决:在 Developer Portal 开启后重启 Gateway

## 学到的新东西
- OpenClaw 的 memory_search 可以跨文件搜索
- Heartbeat 不要太频繁,30 分钟一次最合适

## 关键对话摘录

### 关于定价策略
> 我:你觉得教程定价多少合适?
> AI:参考同类技术教程,建议基础版 ¥99,完整版 ¥199
查看历史对话
如果你想找某天讨论的内容:
你:1 月 15 日我们讨论的定价方案是什么?
AI 会:
-
读取 memory/2025-01-15.md
-
找到相关段落
-
回复你:“那天我们建议基础版 ¥99,完整版 ¥199……”
memory_search:语义搜索
什么是语义搜索?
不是关键词匹配,而是理解含义的搜索。
传统搜索:
- 搜索“登录” → 只找到包含“登录”两个字的内容
语义搜索:
-
搜索“登录” → 找到“JWT 认证”、“session 管理”、“OAuth”等相关内容
-
搜索“省钱” → 找到“Gemini 便宜”、“不要用 Opus 跑 Cron”等相关内容
使用场景
场景 1:找之前的方案
你:我们上次讨论的用户认证方案是什么来着?
AI:(用 memory_search 搜索“用户认证”)
“根据 MEMORY.md,我们决定用 JWT + Refresh Token 方案……
具体设计在 2025-01-10 的日记里有详细记录,要我看一下吗?“
场景 2:找经验教训
你:之前用 Cron 踩过什么坑?
AI:(搜索“Cron 坑”、“Cron 问题”)
“在 2025-01-20 的决策记录里有一条:
❌ 不要在 Cron 里用 Opus(烧钱)
你当时用了 Opus 跑定时任务,一天花了 $50……“
场景 3:找资源链接
你:那个设计稿链接在哪?
AI:(搜索“设计稿”、“Figma”)
“在 MEMORY.md 的活跃项目里:
配图素材:~/Design/openclaw-images/
或者你想找的是博客设计的 Figma?那个在……“
如何触发
你可以直接问:
-
“我们上次讨论的 XXX 是什么来着?”
-
“我之前说过喜欢什么样的风格?”
-
“找找关于定价的讨论”
AI 会自动调用 memory_search 工具。
也可以显式要求:
-
“搜索记忆中关于 Cron 的经验”
-
“查一下 memory,我之前说过用什么数据库?”
最佳实践
- 主动让 AI 记录
好的信息不要让 AI“猜”该不该记,主动说:
“记住这个决定:我们用 PostgreSQL”
“把这个方案记到 MEMORY.md"
“记住我喜欢深色主题”
- 定期整理记忆
建议每周一次:
“整理一下这周的 memory,把重要信息更新到 MEMORY.md"
AI 会:
问题:MEMORY.md 越来越长,AI 读取时 token 消耗大。
解决方案:
-
归档旧项目:已完成的项目移到“归档”区域
-
定期清理:删除过时的偏好、已废弃的技术方案
-
摘要代替全文:大段内容存链接或写摘要
建议长度:保持在 500 行以内。
- 记忆是保险机制
理解 token 限制:
-
Claude 3.5 Sonnet 上下文:200k token
-
一个会话 20-30 轮对话后,早期内容会被“挤出”
-
如果没有记忆文件,这些信息就彻底丢失了
所以:
-
重要信息一定要落到文件
-
不要依赖 AI“记住”会话早期的事
-
定期开启新会话,靠记忆文件保持连贯
故障排除
Q1: AI 说“我检查了记忆但没找到”?
可能原因 1:真的没有记录
-
你从来没让 AI 记过这件事
-
记录在了其他地方(比如聊天记录,不是 memory 文件)
解决方案:
你:直接读取 memory/2025-01-15.md,看看里面有什么
可能原因 2:搜索关键词不匹配
-
你搜“登录”,但记录里写的是“认证”
-
语义搜索也有局限,同义词可能搜不到
解决方案:
-
尝试不同的关键词
-
直接让 AI 读某天的日记
Q2: MEMORY.md 太长了怎么办?
症状:
-
AI 读取 MEMORY.md 消耗大量 token
-
回复变慢、成本增加
解决方案:
- 归档旧项目
## 归档项目

### ~~已完成的项目~~
- [详细信息见 memory/2024-12-01.md]
- 摘要代替全文
## 重要决策
- 2025-01-20:Cron 模型选型策略 [详情见日记]
  - 要点:自动化用 Gemini,日常用 Sonnet,复杂用 Opus
- 分拆文件
memory/
├── active/          # 活跃项目
├── archived/        # 归档项目
└── lessons/         # 经验教训汇总
Q3: AI 记错了信息怎么办?
发现 AI 记错:
AI:“根据 MEMORY.md,你喜欢用 MySQL“
你:“不对,我说的是 PostgreSQL”
修正:
你:“更正一下,我喜欢 PostgreSQL,不是 MySQL。请更新 MEMORY.md"
AI 会立即修正文件。
验证清单
确认记忆系统正常工作:
-
存在 ~/.openclaw/workspace/memory/ 目录
-
存在
~/.openclaw/workspace/MEMORY.md文件 -
AI 自动创建了每日日记(memory/YYYY-MM-DD.md)
-
测试:让 AI 记录一条信息,然后在新会话中询问
-
测试:用“我们上次讨论的……”触发 memory_search
-
每周整理一次 MEMORY.md,保持文件精简
下一步
有了记忆,你的 AI 已经能“记住”你了。下一篇让它真正“动手”干活:
→ 第 06 篇 | 工具调用与 Skills — 让 AI 读写文件、执行命令、操作 GitHub,不只是聊天。
读者讨论
你觉得 AI 最应该记住什么?项目进度?技术偏好?还是其他?
欢迎在评论区分享你的想法!
本系列目录
-
第 01 篇:OpenClaw 是什么?
-
第 02 篇:5 分钟安装指南
-
第 03 篇:连接你的第一个聊天渠道
-
第 04 篇:个性化你的 AI
-
第 05 篇:记忆系统(你在这里)
-
第 06 篇:工具调用与 Skills
-
查看完整目录
下一篇预告:内置工具(文件读写、命令执行、网页搜索)+ Skills 生态(clawhub),让 AI 从“聊天伙伴”变成“得力助手”。*