#3 速度的真相——数据告诉你文档驱动到底快不快
📌 本文是「AI 时代的编码新范式」系列的第 3 篇。全系列共 9 篇,基于 43 篇行业文献、学术论文与一线实践报告,探讨 Spec-Driven Development 如何在 AI Agent 时代从边缘实践变为工程的基础设施。每篇可独立阅读。
2023 年,微软研究院做了一个干净利落的实验:找一批开发者,让他们用 JavaScript 实现一个 HTTP server,越快越好。一半人可以用 GitHub Copilot,另一半不能。
用 Copilot 的那组快了 55.8%。
2025 年,独立研究机构 METR 做了另一个实验:找 16 个经验丰富的开源开发者——平均 5 年该项目的贡献经验——让他们在自己的仓库里修 bug、加功能、做重构。随机分配,一半任务可以用 AI 工具,另一半不能。
用 AI 的那组慢了 19%。
同一个 AI。两个实验。一个飞起来,一个陷进去。这不是「有人说快有人说慢」的罗生门——两个实验都是对的。它们只是测了两种完全不同的使用场景。而这两个数字之间的落差,恰好就是 SDD 存在的全部理由。
先看快的那个:AI 在理想条件下能有多快
Copilot 实验的设计者很清楚自己在干什么。他们没有让开发者去「优化一下这段代码」或者「帮我看看这个 bug」——他们选的是一个教科书级别的原子任务:实现一个 HTTP server。输入边界是「HTTP 协议」这个公开标准,输出边界是「能响应请求的服务端程序」。没有歧义,没有隐式上下文,没有需要跟现有代码风格对齐的约束。
在这种条件下,Copilot 几乎是在替开发者写样板代码。开发者负责想清楚要什么,Copilot 负责打字。快了 55.8%,在这个任务设定下完全合理——不是 AI 有多聪明,而是任务本身就不需要太多「理解」,只需要「翻译」。
OpenAI 自己的内部实验把这个逻辑推到了极限。2025 年 8 月,一个三人工程团队启动了一个新项目——一个内部软件产品的 beta 版。他们给自己定了一条铁律:零行手动代码。所有代码,从应用逻辑到测试到 CI 配置到文档到内部工具,全部由 Codex 生成。
五人月后,仓库里躺着大约一百万行代码。一千五百个 PR,平均每个工程师每天 3.5 个 PR。产品有日常内部用户和外部 alpha 测试者。OpenAI 估计,如果手写,需要十倍的时间。
但如果你以为这个团队只是对着终端说「帮我做一个产品」然后去喝咖啡,那就错过了整件事的核心。
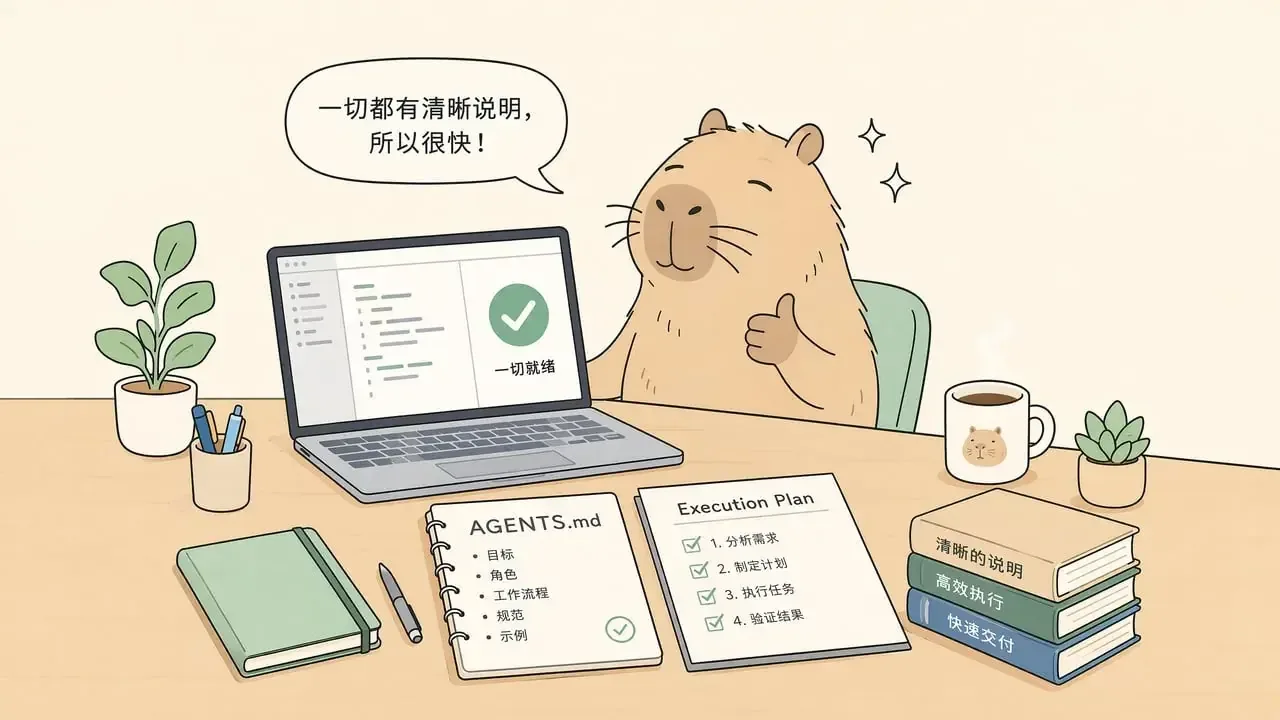
他们做的第一件事,是让 Codex 自己生成了一份 AGENTS.md——告诉 Agent 这个仓库怎么用、规则是什么、文档在哪。他们建了一整套 harness:结构化的 docs 目录、带验证状态和核心设计信念的设计文档、分层的架构文档、按功能域和架构层打分的质量文档。任务计划是第一等工件——小的用轻量计划,复杂的用带进度日志和决策日志的 execution plan,全部签入仓库。还有专门的「文档园艺」Agent 定期扫描过时文档,自动提修 PR。
他们管这套东西叫「progressive disclosure」:Agent 启动时看到的是一份一百行的目录,而不是一千页的手册。Agent 被教会在需要的时候自己去翻更深层的文档,而不是一次性把所有信息塞进上下文。
用他们自己的话说:「早期进展比我们预期的慢——不是因为 Codex 不行,而是环境没有被充分指定。Agent 缺少工具、抽象和内部结构来完成高层的目标。」
换句话说,他们做的第一件事不是写代码。他们做的第一件事是把每一个任务变得边界清晰、上下文完整、验收标准可验证。
然后 Codex 飞起来了。
再看慢的那个:AI 在现实世界里是怎么拖后腿的
METR 的实验从设计上就跟 Copilot 实验站在另一个极端。
十六个开发者,来自平均拥有两万两千颗 GitHub star 的大仓库——例如 PostgreSQL、pandas、scikit-learn 这种级别的项目——每个仓库超过一百万行代码。开发者平均在这个项目上贡献了五年。他们对这些代码库的了解,远远超过任何 AI 工具可能从训练数据里学到的。
任务是真实的:修 bug、加功能、做重构,就是他们平时会做的事。每个任务平均耗时两小时。随机分配是否可以用 AI——允许的那组主要用 Cursor Pro,底层是 Claude 3.5 和 3.7 Sonnet,当时的前沿模型。
实验开始前,开发者自己预测:AI 应该能让我快 24%。实验结束后,他们仍然相信 AI 让他们快了 20%。
实际结果是慢了 19%。
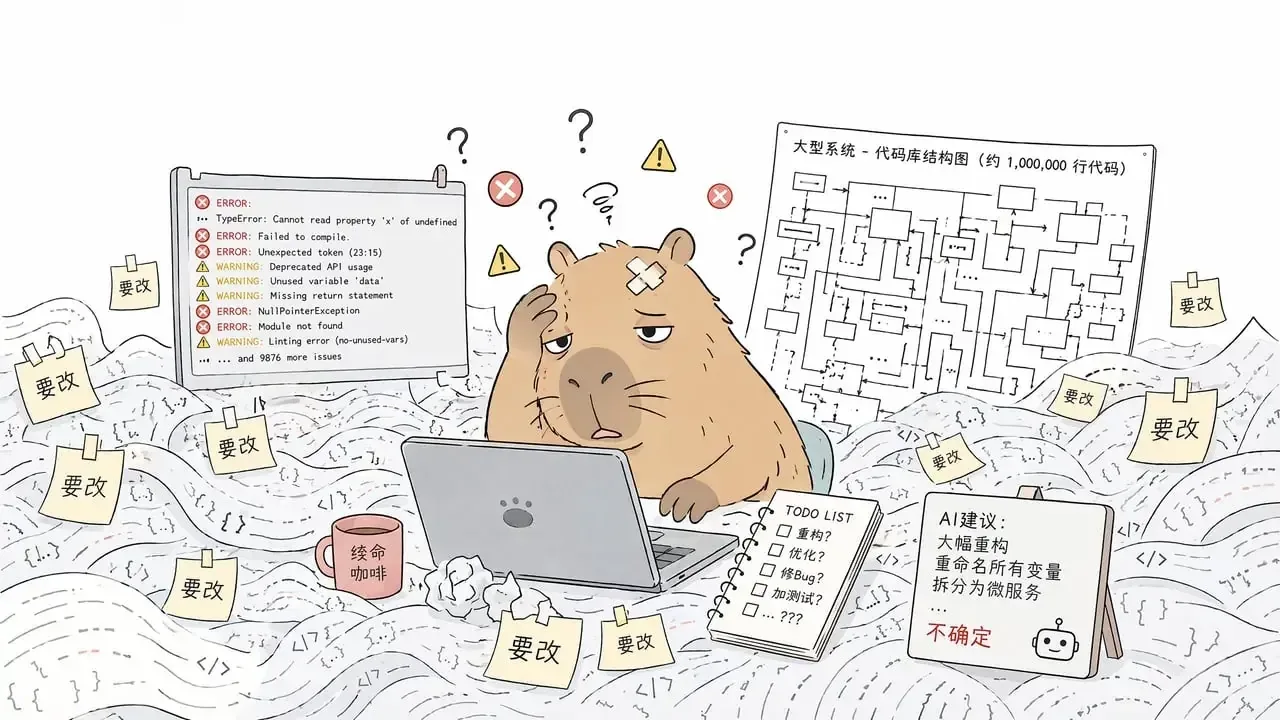
这不是 AI 能力的问题。同类前沿模型在 SWE-bench Verified 等基准测试上普遍表现亮眼——那些任务是从开源 PR 中提取的、有自动化测试的、边界清晰的编程问题。但 METR 的任务不是那样的。它们是散落在百万行代码库里的真实 issue:有时候是你得先花二十分钟理解业务逻辑才能下手的那种;有时候改一个地方要同时改三个模块的测试才能通过的那种;有时候代码逻辑本身没问题,但你不小心引入的副作用会在二十个文件之外爆炸的那种。
METR 团队分析了 20 个可能的解释因素,排除了大部分实验人为问题——开发者不是新手、他们确实按照随机分配使用了或没使用 AI、任务难度在两组之间是均衡的、PR 质量标准也没有因为分组不同而下降。剩下的 5 个可能解释里,最核心的几个指向了同一个方向:
隐式要求和隐性上下文。 高质量的开源项目有严格的编码风格、测试覆盖率要求、文档要求和 linting 规则。这些约束不是在 issue 描述里写的——它们是沉淀在这个仓库的惯例里的,是五年来形成的不成文规则。人类开发者已经内化了这些规则,AI 看不到它们。它生成的代码能通过功能测试,但不符合这个仓库的写法。开发者不得不花额外的时间让 AI 的产出「收敛」到项目标准——改命名、调结构、补测试、修 lint——这些时间加起来,超过了自己写的时间。
这恰好对应了第 1 篇里那个注册页面的故事:Agent 完美实现了它理解的任务,但它理解的任务里不包含「密码要 bcrypt」「错误提示不能泄露其他用户」「不要附带任何关联账户信息」——因为那些约束没有写在任何 AI 能读到的地方。
不同的是,在 Copilot 实验里,任务是「实现一个 HTTP server」——不存在隐式约束,所有规则都在 HTTP 协议里写死了。在 METR 实验里,任务是「修一个 pandas 的 bug」——隐式约束多到任何一份 issue 描述都不可能写全。
DORA 2025 报告从另一个角度看到了同一件事。大规模调查数据显示:AI adoption 每提高 25%,交付吞吐量下降 1.5%,交付稳定性下降 7.2%。根因分析指向同一个机制——AI 让代码产出速度暴增,但 batch size 也大了,review 来不及消化,测试覆盖跟不上。结果不是变快了,是变乱了。
同一个公式:AI 的速度增益 = 任务的结构化程度
做一个完整产品——但团队用 harness 和文档强行把每个子任务都变成了结构化输入。一百行 AGENTS.md 是目录;docs/ 里是全部上下文;execution plan 定义了每一次运行的边界和验收标准。他们不是在写代码——他们是在搭建一台「任务结构化机器」。
METR -19%:任务是真实的、散落在成熟仓库里的、带着大量隐式上下文的编程工作。AI 能做——很多时候产出看起来不错——但把它调成「符合这个仓库标准」的成本超过了收益。
DORA -7.2% stability:宏观视角下的同一规律。AI 加速了「写」这一步,但没有加速「理解约束」和「验证合规」这两步。当写得太快而后两步跟不上,系统整体反而变差。
这不是「AI 有时快有时慢」——是你的任务有时清晰有时模糊。
OpenAI 那篇博客里有一句话把这件事说得很直白:「When something failed, the fix was almost never ‘try harder.’ The human engineers always stepped into the task and asked: what capability is missing, and how do we make it both legible and enforceable for the agent?」
不是让 Agent 更努力。是让任务对 Agent 更可读。
那篇博客还记录了一个更早的教训:「Early progress was slower than we expected, not because Codex was incapable, but because the environment was underspecified.」环境没有被充分指定——翻译成中文就是:他们一开始也没给够约束。当他们开始给 Agent 一份它真正能读懂的「地图」之后,Codex 开始在工程师睡觉的时候跑六个小时的长任务。
METR 的论文在讨论部分也点了同一件事。他们提出了三种可能的解释框架来调和他们的慢速结果和基准测试的亮眼成绩——最可能的一种是「不同测量方法覆盖的是不同子集的任务分布」。那些在 SWE-bench 上轻松满分的问题,和那些在成熟开源仓库里修一个隐式上下文爆棚的 bug,本来就不是同一个物种。
SDD 不是什么方法,是把模糊变成清晰的工具
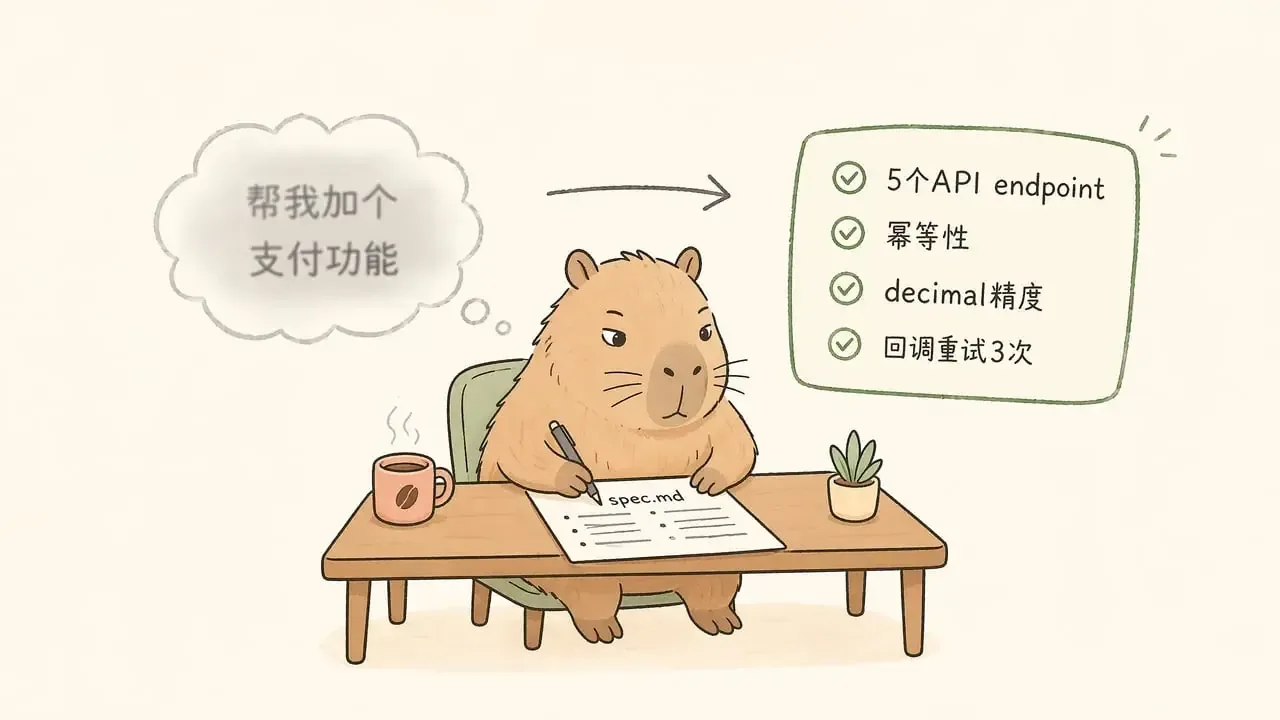 码要哈希、错误提示不区分用户、不暴露他人信息——不在这七个字里,也不在那个平均数里。
METR 实验里那些开发者面对的就是同一个问题的长尾版本。他们的任务不是七个字——可能是一段几十行的 issue 描述——但仍然漏掉了这个仓库五年积累下来的无数隐性规则。Agent 生成的代码在功能上是正确的,在风格上、约定上、副作用管理上是完全错误的。修这些错的时间,超过了省下来写代码的时间。
但如果你把「帮我做一个注册页面」变成——
密码使用 bcrypt,cost factor ≥ 10。错误提示区分「邮箱已注册」和「密码长度不足」,但不附带任何关联账户信息。接口响应不返回其他用户数据——即便是脱敏后的。空字段返回 400 并指明必填项。密码前后空格自动 trim。重复提交由数据库唯一索引兜底。本期不做邮件验证,不做社交登录。
——这时候 Agent 面对的不是七个字和一个模糊画面了。它面对的是一组可验证的条件。生成代码→跑测试→对照 spec 逐行验证→通过就结束,不通过就修。这些条件把任务从结构化程度 30% 推到了 90%。
这 90% 的任务,就是 Copilot 实验里的「实现一个 HTTP server」——边界清晰、验收标准明确、不需要从空气中猜测上下文。这就是 AI 真正能加速的那类任务。
不是巧合。OpenAI 那个零行手写代码的团队,做的就是同一件事——只是规模化地做:为每一个任务写 execution plan,为整个仓库建文档知识库,用 linter 和 CI 确保文档始终反映代码的真实状态,用专门的 Agent 扫描和修复文档漂移。他们的 AGENTS.md 只有一百行,但它指向了一个完整的、结构化的、对 Agent 可读的知识体系。
这套东西不需要一百个人。他们最初只有三个人。
你不信这些数据——你会在自己的项目里重新发现它们
METR 实验里有一个细节,可能是整个实验最值得记住的部分。
开发者在使用 AI 之前预测自己会快 24%。使用 AI 之后——明明实际上慢了 19%——他们仍然认为自己快了 20%。他们的主观感受和客观数据之间,横着将近四十个百分点的误差。
这不是愚蠢。这是人类在评估 AI 时的系统性偏差:你记得 AI 帮你快速生成了那段样板代码的那个瞬间——那个瞬间确实快。你不记得的是你后来改命名、补测试、修 lint 的那二十分钟——因为那是「正常开发工作」,不是「修 AI 的错误」。当这些时间被归到日常开支而不是 AI 问题时,AI 在你的记忆里就只有快的那一面。
但数据不会骗人。计时器不会骗人。
DORA 报告提供了宏观印证:当成千上万个开发者集体报告 AI 让他们「更高效」的时候,组织的交付吞吐量在下降,稳定性在下降。个人感受和系统结果之间的裂缝,就是那些被归入「正常开发工作」的隐性返工时间。
METR 实验的另一个细节同样重要:当开发者不用 AI 的时候,他们并没有变慢。他们在五年的代码库里,凭直觉就知道该改哪个文件、该遵循什么风格、什么样的改动不会在别处引发连锁反应。AI 不但没有帮助这种直觉——它还干扰了它。AI 生成的代码是一个外来物,需要被检查、被修正、被同化到仓库的肌理之中。
但当 OpenAI 的团队做同样的事——在一个新仓库里建一个新产品——他们不需要同化任何东西。Agent 的产出就是仓库的标准,因为从一开始就没有人类写下的标准。
这两种场景的区别不是「新项目 vs 旧项目」,而是「有没有显式化上下文」。一个新项目如果没人写 AGENTS.md、没人建 harness、没人做 execution plan,Agent 一样会乱飞。一个老项目如果有一份足够详尽的 spec——把隐式约束全部显式化——Agent 可以跟在新项目里一样可靠。
不是 AI 时快时慢。是你的任务时清晰时模糊。
回到那两个数字:+55.8% 和 -19%。
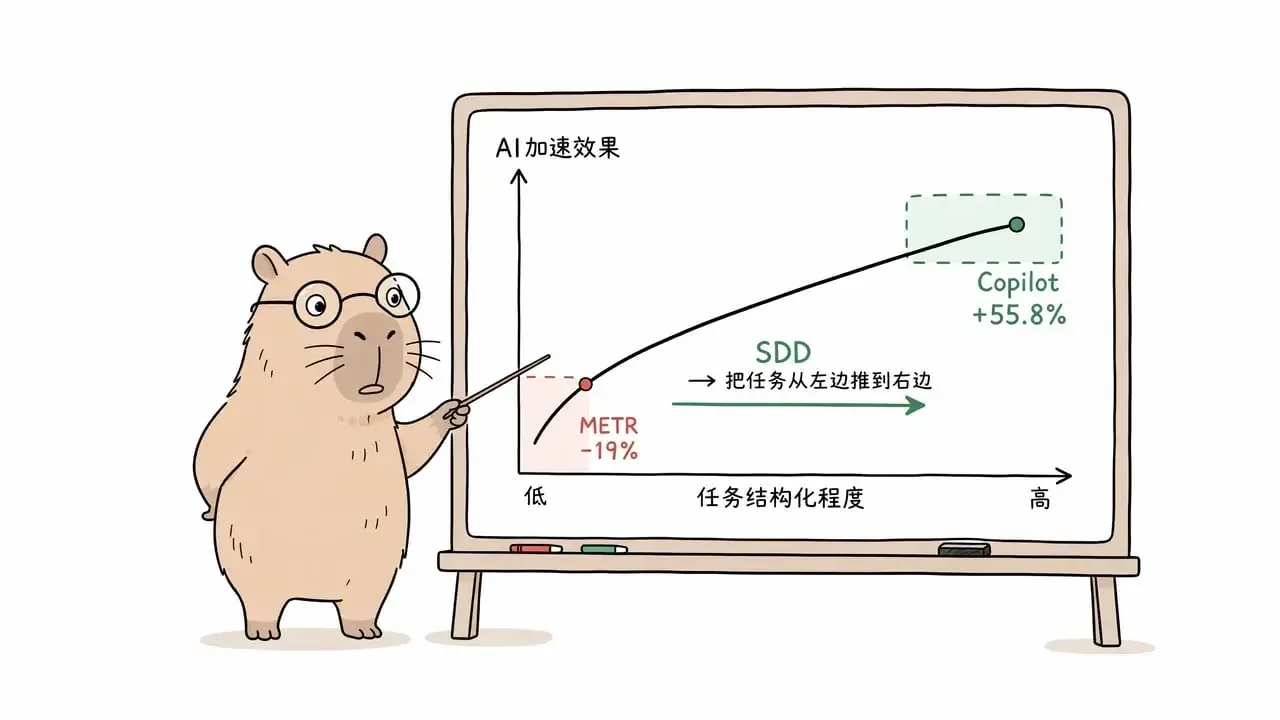
它们不是一个谜题的两个互斥答案。它们是一个公式的两个端点输入。这个公式很简单:你给 Agent 的输入越结构化,AI 的速度增益越大。
Copilot 实验里,任务是天生结构化的——实现一个 HTTP server 没有隐式上下文。OpenAI 团队里,任务是被强行结构化的——他们用 harness、AGENTS.md、execution plan 和文档知识库把每一个任务变成了边界清晰、上下文完整的输入。METR 实验里,任务是天然非结构化的——每一个 issue 都嵌在百万行代码和五年惯例的隐式上下文里,而开发者没有把那些上下文写出来给 Agent 看。
DORA 数据是同一个公式在宏观层面上的表达:当整个行业把 AI 塞进非结构化的流程里,batch size 失控、review 积压、稳定性下降——不是因为 AI 不行,是因为流程没跟上。
SDD 做的是什么?它不写代码。它在你写代码之前,把你脑子里没说出口的那些约束全部搬到 AI 能读到的地方。它把「帮我加个支付功能」变成「实现以下五个 API endpoint:要求满足幂等性、decimal 精度、回调重试最多三次」。前者是 30% 的结构化程度——METR 区间。后者是 90%——Copilot 区间。
OpenAI 团队用了五个月和一整套 harness 来证明这件事可以从头做起。但你不一定需要一个 OpenAI 级别的 harness。你需要的只是在下一次打开 Claude Code 之前,先花十五分钟写明白三件事:什么叫成功了,什么叫越界了,什么不用做。
剩下的,让 Agent 在你睡觉的时候跑。
 ivity: Evidence from GitHub Copilot*](https://www.microsoft.com/en-us/research/publication/the-impact-of-ai-on-developer-productivity-evidence-from-github-copilot/). Microsoft Research. Controlled experiment: Copilot users completed an HTTP server task 55.8% faster.
-
Lopopolo, R. (2026, 推测). Harness Engineering: Leveraging Codex in an Agent-First World. OpenAI Engineering Blog. Internal experiment: 3 engineers, 5 months, ~1M lines of code with 0 lines manually written, ~1/10th the time.
-
METR. (2025). Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity. Randomized controlled trial: 16 experienced developers, 246 tasks, AI use resulted in 19% slower completion. Full paper: arXiv:2507.09089.
-
DORA. (2025). Impact of Generative AI in Software Development. Industry report: 25% increase in AI adoption associated with 1.5% decrease in delivery throughput and 7.2% decrease in delivery stability.