#04 知识引擎——不是笔记工具,是编排基础设施
 战复盘。每篇可独立阅读。前 3 篇讲了知识库、生产管线和 AI 记忆;本篇讲的是:把这些东西装在一起的那个「盒子」——知识引擎本身。
笔记工具的局限
你可能用过 Notion、Obsidian 或者 Apple Notes。它们都是好工具。你可以往里面塞文章、写笔记、做分类、打标签。搜索的时候能找到。界面漂亮。同步流畅。
但当你想让 AI 帮你用这些笔记干点事——比如「从我存的 43 篇文献里找出所有关于 AI 编码速度的,然后帮我写一篇综述」——事情就卡住了。你得把笔记从 Notion 导出来,复制粘贴给 ChatGPT,手动挑出相关条目,手动整理成 AI 能读的格式。用完之后,AI 写的文章你还得手动存回 Notion。下一次写文章,全部从头来过。
这就是笔记工具的天花板:它解决的是「存和找」,不解决「检索 → 综合 → 生产 → 验证」的完整链路。 翻译成人话:笔记工具像一个仓库——东西堆在里面,你需要的时候去找。但仓库不会帮你把原材料加工成成品。
我们在做这个 9 篇文章项目时,用的不是笔记工具。我们用的是 YouMind——一个知识管理平台。但说实话,叫它「知识管理平台」也不够准确。它在我们的项目里扮演的角色更像一个知识引擎:不是存东西的地方,是知识编排的操作系统。
这句话听起来像广告词。让我用具体的事来解释。
语义搜索:不记标题,只记概念
写文章时最频繁的一个动作是「找资料」。笔记工具的搜索方式是关键词匹配——你输入文件名或标签里的某个词,它匹配包含那个词的条目。前提是你得记得你存的东西叫什么名字、打了什么标签。
但我们 43 篇文献的标题五花八门——有学术论文、有公司博客、有行业报告、有 GitHub 仓库。我不可能记住每篇的标题。写第七篇的时候,我需要找关于「AI 让代码产出变快但交付变慢」的数据。如果用关键词搜索,我需要猜:哪篇文献的标题里可能包含「交付速度」这个词?但语义搜索不需要我猜。我只要描述「我想找关于 AI 编码加速但整体交付减速的数据」,系统就能从 43 篇文献里精确找到相关的几篇——因为语义搜索理解的是意思,不是字面。
翻译成人话:关键词搜索像在电话簿里找人——你得知道名字。语义搜索像跟图书管理员说「我想找关于什么什么的书」——你说概念,它帮你匹配。
这件事在写作时的价值不是省了几秒搜索时间。它改变了一个根本性的工作方式:你不需要把精力花在「记住东西存在哪」上,只需要关注「我要找什么」。 这听起来像微小区别,但当你一篇文章要引用十几条来源、每条都要从库里精确找到时,语义搜索和关键词搜索的体验差距是「行云流水」和「翻箱倒柜」的区别。
学术界早在 2026 年前就证明了这个差距。发表在《世界高级研究与评论期刊》上的一篇综述论文引用了 Business Horizons 期刊的研究指出,实施语义搜索的企业,搜索精确度显著提升,查询重写率(翻译成人话就是「第一次没搜到,换个词再搜一次」的频率)大幅下降。而 Deloitte 的企业研究报告的是整体效果:部署 AI 增强知识管理系统的企业,知识工作者定位关键信息的时间明显减少——而知识工作者平均每周有近三分之一的时间花在「找信息」上。
YouMind 给每一条文献、每一篇文章都分配了唯一的 ID。这个 ID 不是给人看的编号——它是 AI 在知识库里定位文件的「地址」。当 MEMORY.md(我们的 AI 记忆文件,上一篇讲过)里记录了「第 7 篇文章的 ID 是 019f3f4f-c81b-7261-90eb-5adfa3043941」时,AI 下次启动会话后可以直接用这个 ID 精确读取那篇文章的全部内容。不需要搜索,不需要猜,零误差。
这为什么重要?因为在跨会话的 AI 写作中,可回溯性不是锦上添花,是质量保证的底线。 我们的文章里每一个数据点都应该能追溯到源头。读者看到「AI 编造率高达 86%」,他应该能点进参考文献看到那个数字来自 Suprmind 的 2026 年基准报告。如果 AI 在写新文章时想引用旧文章的某个数据,它应该能通过 ID 直接读回旧文章确认那个数字——而不是凭记忆重新生成一个可能不一样的数字。
这就是文档 ID 的价值:它让「我记得在哪看过」变成了「我能精确调取」。 前者靠人脑,后者靠系统。人脑会忘,系统不会。
从笔记工具到知识引擎
现在把这些能力拼在一起看。
语义搜索让你用概念找资料,不靠记标题。文档 ID 让每个数据点可精确回溯。MEMORY.md 让 AI 跨会话保持上下文。配图生成统一风格。信息核查作为质量门禁。这些能力单独看各有用处,但它们真正的价值在于组合——合在一起,它们构成了一个完整的知识生产基础设施。
这就是「笔记工具」和「知识引擎」的核心区别。笔记工具——不管它有多漂亮、多流畅——本质上只解决一个环节:存储。你往里面塞东西,你需要的时候去取。检索是关键词的,格式是手动的,生产是外部的,验证靠你自己。
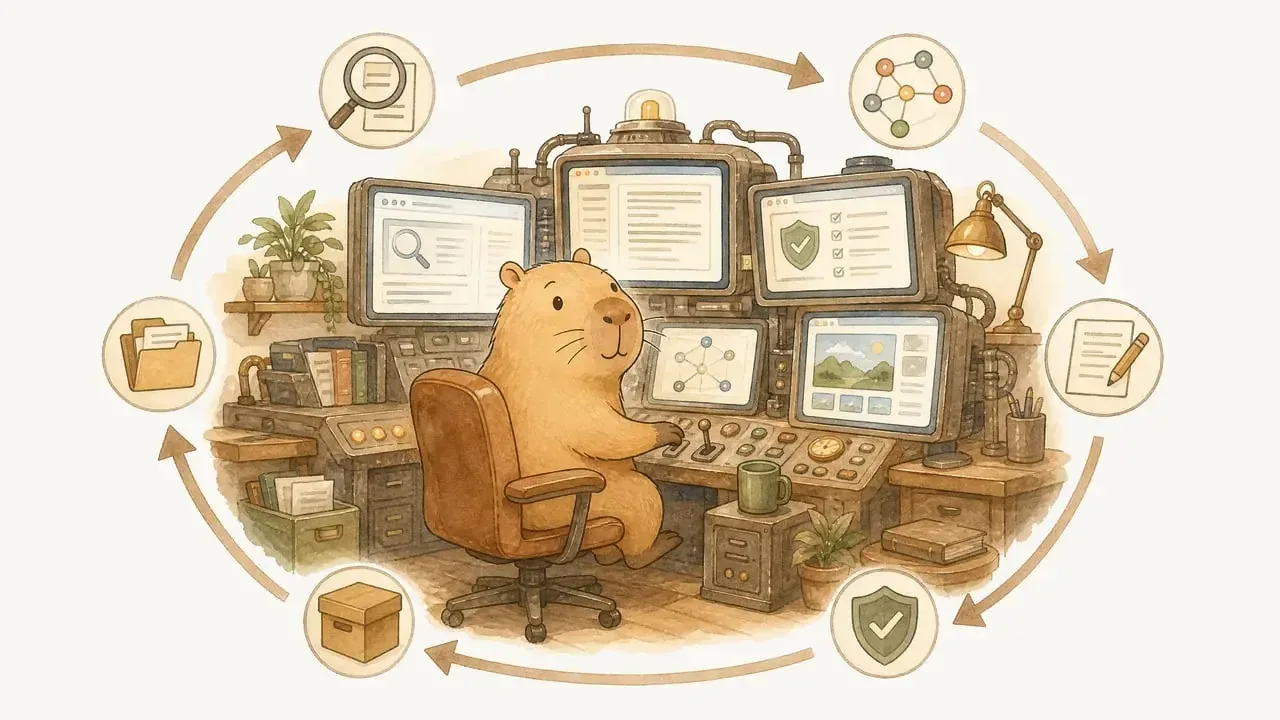
知识引擎解决的是整条链路:检索 → 综合 → 生产 → 验证 → 存储,全部在一个系统内完成。你不需要在五六个工具之间来回切换——在 Notion 里存笔记、在 ChatGPT 里写文章、在 Google 里搜数据、在 Excel 里做核查表、在 Figma 里做配图。所有事情在一个地方完成,而且每一步的产出都可以被下一步直接使用。
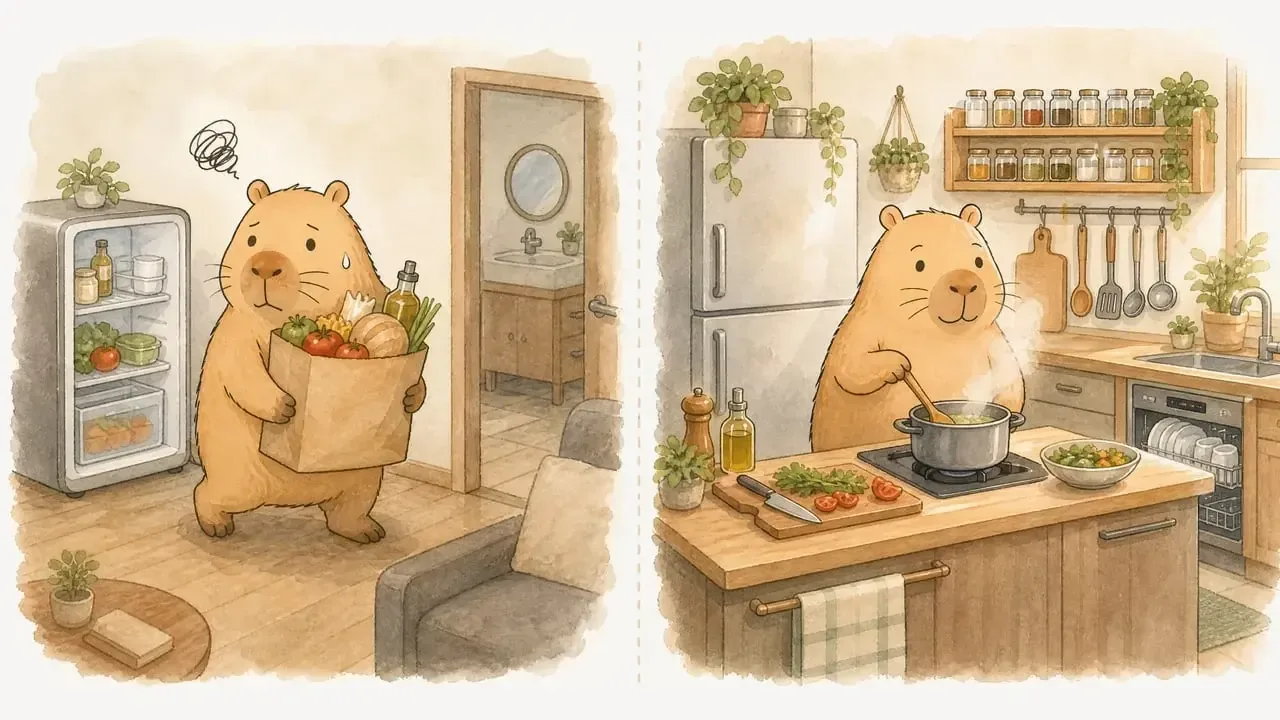
翻译成做饭的类比(我们这个系列喜欢用做饭打比方):笔记工具像一个只有冰箱的厨房——食材存在里面,但灶台、案板、调料架都在别的地方,你得把食材搬来搬去。知识引擎像一个一体化厨房——冰箱、灶台、案板、调料架、洗碗机全在一个空间里,从拿食材到出菜不用离开原地。
和 Karpathy 的「第二大脑」有什么不同
2026 年 4 月,Andrej Karpathy(前特斯拉 AI 总监、OpenAI 创始成员之一,深度学习领域的标杆人物)在 X 上发了一条帖子,描述了他用 AI 管理个人知识的方式。他把它叫「LLM 知识库」——翻译成人话就是「让 AI 帮你把笔记自动整理成结构化的百科全书」。
他的做法是这样的:三个文件夹——一个放原始材料(论文、笔记、对话记录),一个放 AI 自动生成的百科条目(每篇一个 Markdown 文件),一个放查询输出。一个配置文件告诉 AI 规则:拿到新材料时先读现有的百科索引,识别新概念,创建或更新条目,加交叉链接,更新索引。AI 不只是做摘要——它在持续编译一个结构化的知识库,做一致性检查,发现矛盾就标记出来。
结果:一个研究主题就长到了大约 100 篇文章、40 万字——比大多数博士论文还长——而 Karpathy 一个字都没自己直接写。AI 负责写、负责链接、负责分类。他的主要工作是编辑 AI 产出的条目和优化那个配置文件。
Karpathy 做了一件很重要的事:他证明了 AI 可以不只用知识,还能编译知识。从「生成代码」到「生成知识结构」——这是一个范式转变。
但他的方案有一个限制:它停在「生成知识结构」这一步。百科条目生成完了,然后呢?如果你要基于这些条目写一篇面向公众的文章、生成配图、做信息核查——你得离开他的系统,去别的地方完成。
我们的做法更进一步。YouMind 不只是帮你生成知识结构,还支持基于知识结构直接生产内容。翻译成人话:Karpathy 的系统帮你建一个图书馆——书自动整理好上架。YouMind 在此基础上还帮你开了一家出版社——直接从图书馆里取材,写成书,配上封面,校对完,摆到书架上。
这两个方向不是对立的。Karpathy 的「第二大脑」思路解决的是知识管理的自动化——让 AI 替你维护知识库。我们的思路解决的是知识生产的完整链路——从知识库到成品文章,全程在一个系统内完成。两者可以互补:用 Karpathy 的方式自动整理原始知识,再用我们的方式把整理好的知识编排成成品内容。
一个更大的趋势:知识管理正在变天
我们用的工具和 Karpathy 的方案不是孤例。2026 年整个知识管理领域正在经历一场结构性转变。
Glitter AI(一家做 AI 知识管理的公司)的行业报告指出,AI 驱动的知识管理市场从 2024 年的 52.3 亿美元增长到 2025 年的 77.1 亿美元——年增长率 47.2%。到 2029 年预计达到 358.3 亿美元。这不是某个小众赛道的增长——这是整个行业在换引擎。
Glitter AI 的报告引用了 McKinsey 的数据,称知识管理已经成为 AI 应用最广泛的企业功能之一。44% 的专家认为生成式 AI 是当前知识管理最重要的技术。
但报告里有一个关键发现值得注意:最大的采纳差异不在于「有没有 AI」,而在于「AI 是嵌入工作流的还是独立的应用」。 翻译成人话:把 AI 知识管理做成一个独立 App 让员工「去那里查知识」——用率很低。把 AI 知识能力嵌入到员工已有的工具里(Slack、浏览器、邮件)——用率暴增。因为没人愿意为了查一条知识切换到另一个工具。摩擦杀死了使用率。
这和我们前面讲的「一体化厨房」逻辑完全一致。为什么需要知识引擎而不是笔记工具?因为笔记工具是一个「你得主动去打开它」的独立应用,而知识引擎是嵌入在工作流里的——你写文章时搜索、引用、核查、配图,每一步都在同一个环境里完成,不需要切换工具。
Meta 的实践从企业规模上印证了同一个趋势。他们为 6 万名知识工作者构建了 AI 第二大脑系统。用的 PARA 结构(翻译成人话就是按「项目/领域/资源/归档」分类),支持分层加载——AI 先看目录,需要哪部分加载哪部分,不会一上来把所有信息灌进去。我们的 MEMORY.md 规模小得多,但原理一模一样:持久存储、按需加载、跨会话复用。
学术界的论文也确认了这个方向。一篇发表在《世界高级研究与评论期刊》上的研究指出,传统知识管理系统长期受困于三个问题:信息孤岛、人工分类瓶颈、低效搜索。知识工作者将近三分之一的工作时间花在「找信息」而不是「用信息」上。AI 技术正在把静态的、孤立的仓库变成自适应的「知识织物」——持续索引、理解、并在需要时浮现组织知识。
翻译成人话:旧的系统像一个没人维护的仓库——东西堆着,但没人整理,找东西靠翻。新的系统像一个有管理员在值的图书馆——东西被持续整理、分类、更新,你一说要什么,管理员就帮你找到。
你需要什么
回到最开始的问题:笔记工具和知识引擎的区别到底是什么?
笔记工具让你存东西、找东西。这当然有用。如果你的需求是「把文章保存下来以后能找到」——Notion、Obsidian 完全够用。
但如果你要做的是:用 AI 帮你从几十篇文献里检索相关资料,综合成一篇有深度的文章,配上统一风格的插图,逐条核查事实准确性,然后存储成可回溯的知识资产——笔记工具就不够了。你需要的是一个能读、能写、能查、能验证的系统。
这就是知识引擎的定义:不只存东西,还能让 AI 读这些东西、用这些东西生产新东西、验证新东西、然后把新东西存回去成为下一轮的输入。 检索、综合、生产、验证——四步闭环,全部在一个系统内完成。
你可能会说:我用 ChatGPT + Notion + Google + Excel 也凑合能干。当然能。就像你用冰箱 + 微波炉 + 外卖软件也能做饭。但当你每天都要做饭、每顿饭都要走完从备料到出菜的全流程时,一个一体化厨房的价值就显现了——不是每一步都做得更好,而是步骤之间不需要搬运。
我们 7 天产出 9 篇文章的效率,不只是 AI 的功劳。AI 是发动机,知识引擎是底盘。没有底盘,发动机再强也只是原地空转。
你需要的不只是一个存笔记的地方——你需要一个能读、能写、能查、能验证的知识操作系统。
参考文献
-
Karpathy, A. (2026). LLM Knowledge Base: Build Your Second Brain. 三文件夹架构(raw/wiki/outputs),LLM 自动编译结构化知识库,100 篇文章 40 万字。从「生成代码」到「生成知识结构」的范式转变。https://codersera.com/blog/karpathy-llm-knowledge-base-second-brain/
-
Glitter AI. (2026). AI for Knowledge Management: 2026 Trends & Applications. AI KM 市场 2024 年 52.3 亿美元 → 2025 年 77.1 亿美元(CAGR 47.2%)→ 2029 年预计 358.3 亿美元。McKinsey:知识管理是 AI 应用最广泛的企业功能之一,44% 专家认为生成式 AI 是当前 KM 最重要技术。嵌入式 vs 独立应用采纳率差异巨大。https://www.glitter.io/blog/knowledge-sharing/ai-knowledge-management
-
Gadde, A. (2025). AI-enhanced Knowledge Management Systems in Enterprises. World Journal of Advanced Research and Reviews, 26(02), 2020-2030. 传统 KM 受困于信息孤岛、人工分类瓶颈、低效搜索。知识工作者近 1/3 时间花在找信息。语义搜索显著提升搜索精确度,降低查询重写率。RAG 框架提升事实准确性。https://wjarr.com/sites/default/files/fulltext_pdf/WJARR-2025-1913.pdf
-
Meta. (2026). How We Built an AI Second Brain for 60K Knowledge Workers. 为 6 万知识工作者构建 AI 第二大脑。PARA 结构支持分层加载,主动 Agent 按计划运行。持久存储、按需加载、跨会话复用。https://medium.com/@AnalyticsAtMeta/how-we-built-an-ai-second-brain-for-60k-knowledge-workers-78c507dd795b
-
MindStudio. (2026). How to Build an AI Second Brain Knowledge Base. AI 第二大脑四层架构:捕获层(Capture)→ 处理层(Processing)→ 存储层(Storage)→ 检索层(Retrieval)。普通知识库是可搜索的档案;AI 第二大脑增加推理层:摘要、标记、关联、问答。检索层是系统价值的关键。https://www.mindstudio.ai/blog/how-to-build-ai-second-brain-knowledge-base
-
SDD 博客系列项目(自有数据). YouMind 作为知识引擎:43 篇文献语义搜索检索 → 文档 ID 可回溯 → MEMORY.md 跨会话上下文 → 配图统一风格生成 → 信息核查质量门禁 → 9 篇文章 × 6 张配图 → X 7 天 1,000+ 关注 → 付费博客 300 美元营收。link